Nhận dạng giọng nói đã lặng lẽ mở trọng số — và chỉ nặng 1,56 GB
Các mô hình Qwen3-ASR của Alibaba dùng giấy phép Apache 2.0, hỗ trợ 52 ngôn ngữ và phương ngữ, tải về chưa tới hai gigabyte. Một hướng dẫn dễ hiểu về tầng phiên âm mở trọng số: hiện có những gì, chạy mô hình trên máy tính của chính bạn thực sự được gì, và các API đóng vẫn thắng ở đâu.
Bạn có thể chạy nhận dạng giọng nói mở trọng số ngay trên laptop: nhóm Qwen của Alibaba phát hành Qwen3-ASR-0.6B, Qwen3-ASR-1.7B và mô hình đi kèm Qwen3-ForcedAligner-0.6B theo giấy phép Apache 2.0. Bản tải nhỏ nhất nặng 1,56 GB, hỗ trợ 52 ngôn ngữ và phương ngữ, và từ ngày 26 tháng 6 có thể chạy bằng ba dòng Python tiêu chuẩn. Chạy trên máy của mình giúp tránh hóa đơn phiên âm tính theo từng yêu cầu.
Sự chuyển dịch này sẽ quen thuộc với bất kỳ ai theo dõi các mô hình ngôn ngữ mở: tự vận hành giúp kiểm soát chi phí, quyền riêng tư và khả năng dùng ngoại tuyến tốt hơn, còn API lưu trữ sẵn vẫn dễ vận hành hơn. Nhận dạng giọng nói đang đi theo lựa chọn tương tự, với những mô hình đủ nhỏ để chạy cục bộ.
Bài hướng dẫn này giải thích nhận dạng giọng nói mở trọng số làm được gì, các mô hình và giấy phép hiện có khác nhau ra sao, mô hình nhỏ có thể chạy trên thiết bị nào, và API lưu trữ sẵn vẫn có lợi thế ở đâu.
TL;DR:
- Phiên âm mở trọng số đã dùng được ngay hôm nay: Qwen3-ASR theo Apache 2.0 với 52 ngôn ngữ và phương ngữ, Whisper theo MIT, Parakeet và Canary của NVIDIA theo CC BY 4.0, Voxtral của Mistral theo Apache 2.0.
- Tự vận hành mang lại quyền riêng tư, hoạt động ngoại tuyến và kiểm soát chi phí. Trên bảng xếp hạng độc lập Artificial Analysis, lưu trữ một mô hình mở tốn 1,50 đô la cho mỗi 1.000 phút, so với 6,00 đô la của MAI-Transcribe-1.5 của Microsoft và 18,15 đô la của Gemini 3.1 Pro Preview.
- Vị trí số một về độ chính xác vẫn là một điểm cuối bản xem trước đóng. Nhưng một mô hình mở theo Apache 2.0 là Voxtral Small đã đứng thứ năm, chỉ cách khoảng một điểm phần trăm tỷ lệ lỗi từ.
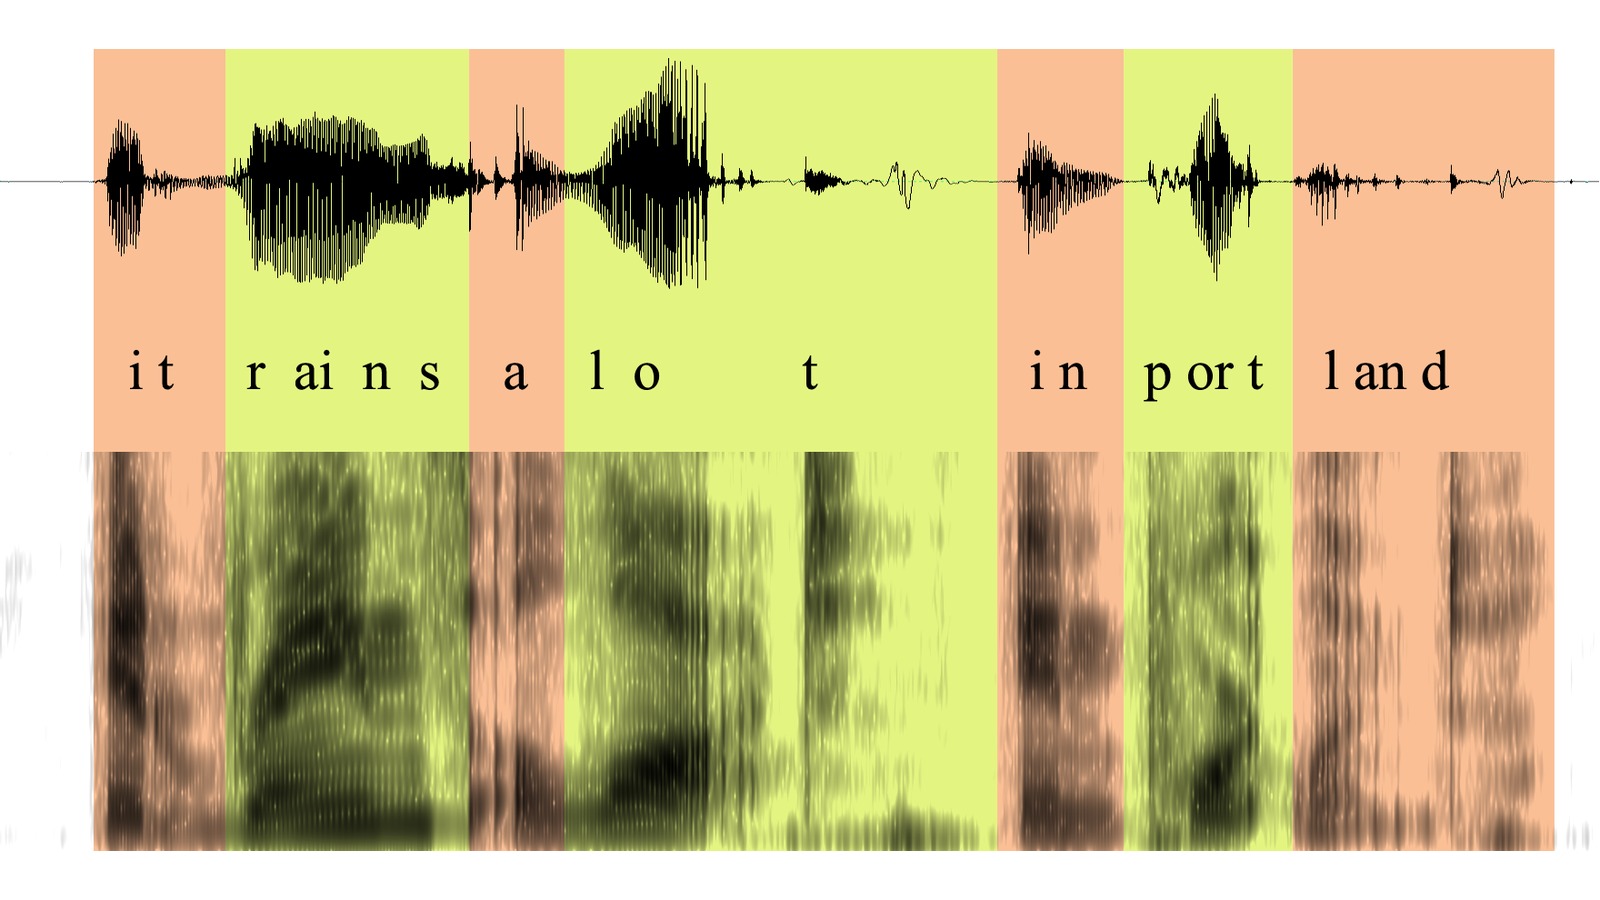
Hình: Aaron Parecki, Wikimedia Commons, CC BY 2.0. Dạng sóng và phổ đồ của câu "it rains a lot in Portland", các chữ cái được đặt ngay phía trên đoạn âm thanh tương ứng — đây chính là nguyên liệu thô mà mọi mô hình nhận dạng giọng nói phải xử lý.
Bạn thực sự tải về cái gì khi tải một mô hình phiên âm
Mô hình ASR — nhận dạng giọng nói tự động, dùng thay thế cho STT hay chuyển giọng nói thành văn bản — là một chương trình nhận âm thanh vào và cho ra văn bản. Công việc chỉ có vậy. Nó không xác định ai đã nói, không tóm tắt, không biết cuộc họp của bạn bàn về chuyện gì. Nó nghe từ ngữ và chép lại.
"Mở trọng số" nghĩa là phòng thí nghiệm đã công bố chính tệp mô hình hoàn chỉnh. Trọng số của một mô hình là lưới số khổng lồ mà nó học được trong quá trình huấn luyện, và công bố chúng nghĩa là bạn tải tệp đó về, chạy trên phần cứng của mình và xây dựng bên trên mà không phải xin phép ai hay trả tiền theo lượt gọi. Phía ngược lại là mô hình đóng: trọng số nằm trên máy chủ của nhà cung cấp, còn bạn thuê quyền truy cập qua API — âm thanh gửi lên, văn bản trả về, tính tiền theo phút.
Con số trong tên là số tham số, và với mô hình giọng nói thì con số này cụ thể một cách khác thường. "0.6B" nghĩa là khoảng 600 triệu tham số, trên thực tế khiến Qwen3-ASR-0.6B là một tệp 1,56 GB và Qwen3-ASR-1.7B là 4,08 GB — cả hai đều đủ nhỏ để nằm trên ổ SSD laptop mà chẳng ai để ý. Hãy so với các mô hình ngôn ngữ mở mà chúng tôi đã viết trong bài tổng hợp về Trung Quốc, nơi bản phát hành chủ lực nặng 1,56 terabyte chia thành 96 mảnh và cần cả một cụm máy chỉ để nạp. Mô hình giọng nói nhỏ hơn mô hình văn bản tiên tiến khoảng một nghìn lần, và riêng sự thật đó giải thích vì sao bước chuyển này ở đây có sức nặng hơn hồi đó.
Gọi dải kích cỡ này là hạng laptop: các mô hình đủ nhỏ để việc thử nghiệm trở thành chuyện tải xuống, thay vì quyết định về ngân sách phần cứng. Hầu hết mô hình văn bản tiên tiến vẫn nằm ngoài nhóm này; nhiều mô hình giọng nói thì vừa vặn.
Hãy kiểm tra giấy phép trước khi chọn mô hình. Apache 2.0 và MIT cho phép sử dụng, chỉnh sửa và phân phối thương mại; CC BY 4.0, được NVIDIA dùng cho các mô hình của mình, cũng cho phép dùng thương mại nhưng yêu cầu ghi công.
Qwen phát hành họ mô hình này từ tháng Giêng; tháng Sáu mới là lúc nó trở nên dễ dùng
Qwen3-ASR xuất hiện lần đầu vào ngày 28 tháng 1 năm 2026, và báo cáo kỹ thuật được đăng trên arXiv vào ngày hôm sau. Ngày 26 tháng 6, Qwen công bố các phiên bản -hf của cả ba mô hình, tương thích với Hugging Face Transformers từ phiên bản 5.13.0 trở đi.
Thay đổi cách đóng gói giúp việc thiết lập quen thuộc hơn: thay vì cài gói qwen-asr của Qwen hoặc backend vLLM, nhà phát triển dùng Transformers có thể nạp các checkpoint -hf bằng Python tiêu chuẩn. Điều này giảm công sức thiết lập mà không thay đổi khả năng nhận dạng của mô hình.
Thẻ mô hình liệt kê khả năng nhận diện ngôn ngữ và nhận dạng giọng nói bằng 30 ngôn ngữ — gồm tiếng Anh, Trung, Hàn, Nhật, Tây Ban Nha, Ả Rập, Hindi, Thái, Việt và Ba Lan — cộng thêm 22 phương ngữ tiếng Trung, tổng cộng 52 ngôn ngữ và phương ngữ. Cả hai kích cỡ đều hỗ trợ suy luận trực tuyến và ngoại tuyến bằng cùng một mô hình, nhận âm thanh dài, và liệt kê giọng hát cùng bài hát có nhạc nền trong số các loại âm thanh được hỗ trợ.
Qwen3-ForcedAligner-0.6B bổ sung khả năng căn chỉnh cưỡng bức: khi có âm thanh và bản phiên âm, mô hình đánh dấu thời điểm bắt đầu và kết thúc của từng từ với độ chính xác tới mili giây, trên 11 ngôn ngữ và các đoạn ghi âm dài tối đa năm phút. Nhờ đó có thể tạo bản phiên âm tương tác, căn thời gian phụ đề và nhảy tới đúng khoảnh khắc một từ được nói. Việc phát hành bộ căn chỉnh cùng bộ nhận dạng khiến cả họ mô hình hữu ích cho việc xây dựng sản phẩm phiên âm, không chỉ chạy bản demo.
Thẻ mô hình của Qwen báo cáo kết quả từ Hugging Face Open ASR Leaderboard ngày 26 tháng 6 năm 2026: tỷ lệ lỗi từ trung bình là 5,59 % với mô hình 1.7B và 6,31 % với 0.6B; trên tập âm thanh cuộc họp AMI, các con số lần lượt là 9,26 % và 10,57 %. Tỷ lệ lỗi từ thấp hơn nghĩa là ít từ bị nhận sai hơn. Qwen mô tả mô hình 1.7B là tiên tiến nhất trong nhóm ASR mở và có thể cạnh tranh với API thương mại; đây là kết quả do nhà cung cấp báo cáo. Bảng độc lập bên dưới dùng tập âm thanh khác nên điểm số không thể so sánh trực tiếp.
Whisper đã khởi đầu chuyện này, và vẫn là mô hình ai cũng chạy
Không có Whisper của OpenAI thì mọi thứ đã không có hình dạng như bây giờ. Kho mã được mở công khai ngày 16 tháng 9 năm 2022 theo giấy phép MIT — cả mã lẫn trọng số — vào thời điểm mà nhận dạng giọng nói nghiêm túc đồng nghĩa với một hợp đồng với nhà cung cấp đám mây. Từ đó tới nay nó đã gom được 106.679 sao trên GitHub.
Điều làm Whisper trở nên quan trọng ít nằm ở bản thân mô hình hơn là ở những gì cộng đồng dựng lên trên nó chỉ trong vài tháng. whisper.cpp viết lại nó bằng C và C++ thuần, giấy phép MIT, 52.591 sao, và khiến nó chạy được trên laptop lẫn điện thoại mà không cần Python cũng chẳng cần GPU. faster-whisper dựng lại nó trên CTranslate2 với mức cải thiện lớn về tốc độ và bộ nhớ, cũng MIT, 24.750 sao. Mô hình là hạt giống; hệ sinh thái mới là cái cây.
Bốn năm sau, Whisper vẫn được sử dụng rộng rãi. Trong 30 ngày trước ngày 5 tháng 8 năm 2026, whisper-large-v3-turbo được tải 8,72 triệu lần từ Hugging Face và whisper-large-v3 được tải 5,50 triệu lần; Qwen3-ASR-0.6B đạt 4,29 triệu lượt. Trên bảng Artificial Analysis, Whisper Large v3 đạt 4,07 % AA-WER, so với 1,73 % của mô hình dẫn đầu trong ảnh chụp dữ liệu đó.
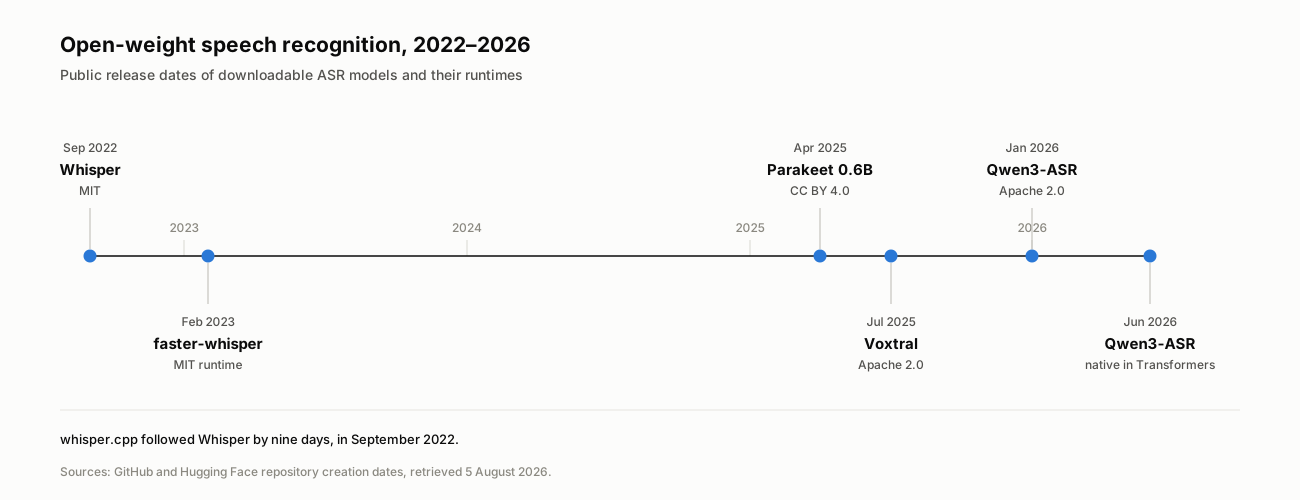
Tầng giọng nói mở đến theo hai đợt cách nhau ba năm, giữa hai đợt gần như trống. Ngày phát hành lấy từ GitHub và Hugging Face, truy xuất ngày 5 tháng 8 năm 2026.
Phía mở không chỉ có một phòng thí nghiệm
Qwen không đơn độc, và những cái tên còn lại giỏi ở những chỗ khác nhau rõ rệt.
Dòng Parakeet của NVIDIA tập trung vào tốc độ. parakeet-tdt-0.6b-v3, phát hành tháng 8 năm 2025 theo CC BY 4.0, có 600 triệu tham số, hỗ trợ 25 ngôn ngữ châu Âu và nhận diện ngôn ngữ tự động, dấu câu, viết hoa cùng dấu thời gian theo từ cho đoạn âm thanh dài tối đa 24 phút mỗi lượt. Họ Canary của NVIDIA — canary-1b-v2 và canary-qwen-2.5b, cũng theo CC BY 4.0 — có các khả năng tương tự. Những mô hình Voxtral của Mistral, phát hành tháng 7 năm 2025 theo Apache 2.0, nằm gần đầu bảng so sánh độc lập bên dưới.
Đây là phía mở đặt cạnh nhau, hàng cuối là một API lưu trữ sẵn để đối chiếu.
| Mô hình | Tải về | Giấy phép | Ngôn ngữ | Chạy trên | Mạnh nhất ở |
|---|---|---|---|---|---|
| Whisper Large v3 | 3,09 GB | MIT | 99 | Laptop hoặc một GPU | Là lựa chọn mặc định mà mọi công cụ đã hỗ trợ |
| Qwen3-ASR-0.6B | 1,56 GB | Apache 2.0 | 52 kể cả phương ngữ | Laptop | Đa ngôn ngữ ở kích cỡ nhỏ nhất |
| Qwen3-ASR-1.7B | 4,08 GB | Apache 2.0 | 52 kể cả phương ngữ | Laptop hoặc một GPU | Độ chính xác cao nhất trong họ Qwen |
| Parakeet TDT 0.6B v3 | 2,51 GB | CC BY 4.0 | 25 ngôn ngữ châu Âu | Laptop hoặc một GPU | Tốc độ và dấu thời gian theo từ |
| Voxtral Small | — | Apache 2.0 | — | GPU máy chủ, 24 tỷ tham số | Điểm cao nhất của mô hình mở trên bảng độc lập |
| API lưu trữ sẵn | Không tải về được | Đóng | Tùy nhà cung cấp | Đám mây của nhà cung cấp | Phân tách người nói, truyền luồng, thời gian hoạt động |
Dung lượng tải về là checkpoint mặc định trong mỗi kho Hugging Face. "—" cho biết tài liệu nguồn dùng cho phần so sánh này không cung cấp giá trị đó. Ảnh chụp dữ liệu lấy ngày 5 tháng 8 năm 2026.
Rồi còn lớp công việc đóng gói đưa các mô hình này lên thiết bị thật, đúng chỗ mà hạng laptop thôi là lý thuyết. whisperkit-coreml — Whisper biên dịch cho phần cứng Apple — được tải 8,31 triệu lượt trong 30 ngày qua. Một bản dựng MLX của Parakeet cho Apple Silicon đạt 1,87 triệu, và hai bản chuyển đổi GGUF — định dạng lượng tử hóa giúp mô hình chạy trên CPU thường — đạt 2,04 triệu và 1,87 triệu. Mỗi tháng có hàng triệu người tải về phần mềm nhận dạng giọng nói được đóng gói riêng để chạy trên máy của chính họ. Đó không phải chuyện lạ trong nghiên cứu. Đó là một kênh phân phối.
Vị trí số một vẫn là điểm cuối bản xem trước mà bạn không tải về được
Phần so sánh này tách độ chính xác nhận dạng khỏi lợi ích vận hành khi tự chạy mô hình.
Bảng chuyển giọng nói thành văn bản của Artificial Analysis, được truy xuất ngày 5 tháng 8 năm 2026, đo các mô hình mở và đóng trên cùng một tập âm thanh. Kết quả AA-WER v2 gồm:
| Hạng | Mô hình | AA-WER | Tải về được? |
|---|---|---|---|
| 1 | Fun-Realtime-ASR-preview | 1,73 % | Không — điểm cuối bản xem trước |
| 2 | Scribe v2, ElevenLabs | 2,18 % | Không — API lưu trữ sẵn |
| 3 | MAI-Transcribe-1.5, Microsoft | 2,38 % | Không — API lưu trữ sẵn |
| 4 | Smallest AI Pulse Pro | 2,43 % | Không — API lưu trữ sẵn |
| 5 | Voxtral Small, Mistral | 2,77 % | Có — Apache 2.0 |
| 6 | Gemini 3.1 Pro Preview, High | 2,82 % | Không — API lưu trữ sẵn |
| 11 | Whisper Large v3 | 4,07 % | Có — MIT |
Nguồn: bảng xếp hạng chuyển giọng nói thành văn bản của Artificial Analysis, AA-WER v2, lấy ngày 5 tháng 8 năm 2026. Khả năng tải về được đánh giá theo giấy phép công bố của từng mô hình.
Bốn dòng đầu cho thấy những mô hình đạt điểm cao nhất trong ảnh chụp này đều được lưu trữ sẵn, còn mô hình dẫn đầu là điểm cuối xem trước chứ không phải mô hình tải xuống được.
Voxtral Small theo Apache 2.0 và đứng thứ năm với 2,77 %, thấp hơn mô hình xem trước đóng dẫn đầu khoảng một điểm phần trăm. Với cuộc họp một giờ có 6.300 từ, chênh lệch đó tương đương khoảng 66 từ. Đây là khoảng cách có thật, nhưng không phải trở ngại không thể vượt qua với những nhóm coi trọng việc triển khai cục bộ.
Với nhiều khối lượng công việc, mô hình giọng nói mở đã đủ dùng; lựa chọn còn lại là liệu chênh lệch độ chính xác vừa phải có đáng để đổi lấy quyền kiểm soát khi tự vận hành hay các tính năng đi kèm dịch vụ lưu trữ sẵn có xứng với chi phí.
Tự chạy thì được gì và mất gì
Có ba thứ đẩy các đội nhóm về phía tự vận hành, và không thứ nào là độ chính xác.
Quyền riêng tư là thứ nhất và thường mang tính quyết định. Nếu bạn phiên âm buổi khám bệnh, phỏng vấn pháp lý hay các cuộc trao đổi nhân sự, "âm thanh không rời khỏi phần cứng của chúng tôi" không phải sở thích mà là yêu cầu mua sắm, và mô hình do bạn tự vận hành là kiến trúc duy nhất đáp ứng gọn ghẽ điều đó. Hoạt động ngoại tuyến là thứ hai: mô hình nằm trên thiết bị vẫn chạy trên máy bay, dưới tầng hầm, giữa xưởng sản xuất, ở hiện trường không sóng. Chính vì thế mà whisper.cpp và các bản dựng GGUF có lượt tải như hiện nay.
Chi phí là thứ ba, và các con số ở đây khá phũ. Vẫn từ ảnh chụp của Artificial Analysis, giá cho mỗi 1.000 phút âm thanh: Whisper Large v3 chạy trên fal.ai là 0,50 đô la, Canary Qwen 2.5B của NVIDIA trên Replicate là 0,74, Parakeet TDT 0.6B V3 trên Together AI là 1,50. Phía đóng thì Nova-3 của Deepgram là 4,30, MAI-Transcribe-1.5 là 6,00, còn Gemini 3.1 Pro Preview là 18,15. Đó là chênh 4 lần so với Microsoft và 12 lần so với Google, chỉ tính riêng việc chạy một mô hình mở trên máy chủ của người khác — chưa xét tới chuyện chạy trên máy của chính bạn, nơi chi phí biên của giờ thứ một nghìn là tiền điện.
Các số liệu tốc độ trong cùng ảnh chụp dữ liệu cho thấy Parakeet TDT 0.6B V3 chạy trên Together AI dẫn đầu ở mức 885 lần thời gian thực — xử lý một giờ âm thanh trong khoảng bốn giây. Nova-3 của Deepgram đạt 512x, Whisper Large v3 trên Together đạt 478x, còn MAI-Transcribe-1.5 đạt 189x. Lựa chọn nhanh nhất trong danh sách là mô hình mở trọng số, nhưng kết quả này đo dịch vụ lưu trữ của Together AI chứ không phải phần cứng cục bộ.
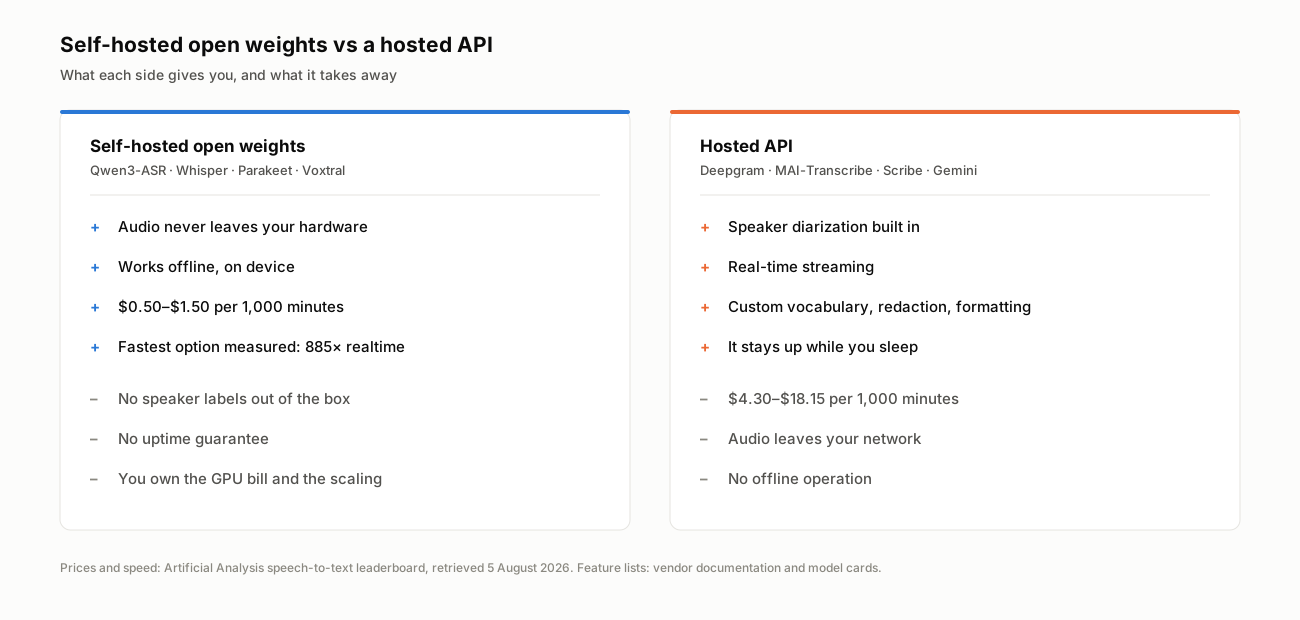
Cuộc đánh đổi chưa bao giờ là độ chính xác đấu với độ chính xác. Đó là quyền kiểm soát và chi phí đấu với những tính năng bọc quanh phần nhận dạng.
Vậy các API lưu trữ sẵn còn bán gì? Bán tất cả những gì không phải nhận dạng. Tài liệu của Deepgram là một bản kiểm kê sòng phẳng: phân tách người nói, truyền theo luồng thời gian thực, định dạng, từ vựng tùy chỉnh, che thông tin định danh, phát hiện ngôn ngữ, và bảo đảm vận hành rằng dịch vụ vẫn sống trong lúc bạn ngủ. Tải Qwen3-ASR về, bạn có từ ngữ và dấu thời gian. Không nhãn người nói, không SLA, và hóa đơn GPU, việc mở rộng quy mô cùng cú gọi lúc ba giờ sáng đều là của bạn.
Mô hình được tải nhiều nhất trong hạng mục này lại không phải mô hình phiên âm
Xu hướng tải xuống cũng cho thấy nhu cầu nhận diện người nói bên cạnh phiên âm.
Khi sắp xếp toàn bộ hạng mục nhận dạng giọng nói tự động trên Hugging Face theo lượt tải, mô hình đứng đầu không phải Whisper, không phải Qwen, cũng chẳng phải Parakeet. Đó là pyannote/speaker-diarization-3.1 với 8,91 triệu lượt tải trong 30 ngày qua, và một mô hình phân tách người nói khác của pyannote đứng thứ năm với 5,26 triệu. Phân tách người nói là bộ máy xác định ai đã nói vào lúc nào — chính là tầng ngay phía trên phiên âm.
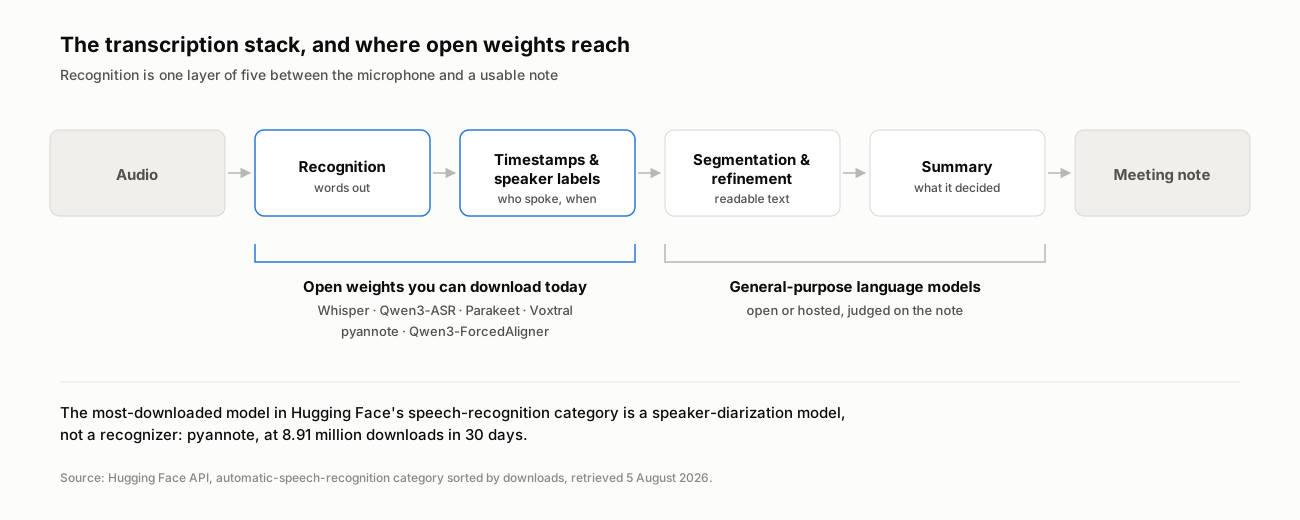
Mô hình mở nay đã phủ hai tầng dưới cùng. Những tầng quyết định bản ghi chú có dùng được hay không nằm ở phía trên.
Mô hình được tải nhiều nhất trong hạng mục nhận dạng giọng nói không nhận dạng lời nói; nó xác định ai đã nói vào lúc nào. Nhu cầu đó hướng tới lớp nằm trên phiên âm, nơi nhãn người nói giúp biến những từ đã nhận dạng thành bản ghi cuộc họp hữu ích. Điều này cũng phản ánh khoảng trống sản phẩm được mô tả trong phân tích của chúng tôi về thị trường đóng.
Chốt lại
Câu hỏi thú vị về nhận dạng giọng nói mở trọng số chưa bao giờ là "nó có tốt bằng các mô hình đóng không". Nó chỉ kém chừng một điểm phần trăm tỷ lệ lỗi từ, nó nhanh hơn, rẻ hơn từ bốn tới mười hai lần, và nằm gọn trên một chiếc laptop. Câu hỏi thú vị là bạn sẽ xây gì trong khoảng trống mở ra khi phiên âm thôi là một khoản chi đi thuê — bởi một tệp 1,56 GB nghe được 52 ngôn ngữ không phải là sản phẩm. Nó là một linh kiện vừa trở nên miễn phí.
Với một đội đang chọn công cụ ghi chú cuộc họp chứ không phải chọn mô hình, phần cần đọc rất ngắn. Việc một sản phẩm chạy mô hình mở hay API đóng giờ phần lớn chỉ là chi tiết triển khai, và ngày càng sẽ là cả hai: trọng số mở cho phần việc khối lượng lớn, API lưu trữ sẵn ở những chỗ mà phân tách người nói, truyền luồng và quy mô xứng với giá tiền. Telli.sh vốn đã chạy một mô hình mở ở tầng tóm tắt, nên mọi tiến bộ ở phía mở chảy thẳng vào phiên âm, dịch thuật và ghi chú cuộc họp mà không đổi giá. Hãy đánh giá công cụ bằng thứ đi ra ở cuối: bản ghi chú có cho bạn biết ai đã nhận làm việc gì hay không.
Nguồn
- Thẻ mô hình Qwen3-ASR-0.6B-hf (Hugging Face) — giấy phép, danh sách ngôn ngữ, số liệu bảng xếp hạng đề ngày 26 tháng 6 năm 2026
- Thẻ mô hình Qwen3-ASR-1.7B-hf (Hugging Face)
- Qwen3-ForcedAligner-0.6B (Hugging Face)
- Qwen3-ASR Technical Report, arXiv:2601.21337 (nộp ngày 29 tháng 1 năm 2026)
- Kho mã OpenAI Whisper (MIT, công bố ngày 16 tháng 9 năm 2022)
- whisper.cpp và faster-whisper
- Thẻ mô hình NVIDIA parakeet-tdt-0.6b-v3 (CC BY 4.0)
- Mistral Voxtral-Small-24B-2507 (Apache 2.0)
- Bảng xếp hạng chuyển giọng nói thành văn bản của Artificial Analysis — AA-WER v2, số liệu tốc độ và giá lấy ngày 5 tháng 8 năm 2026
- Hugging Face Open ASR Leaderboard
- Tài liệu Deepgram về phân tách người nói
- Trang hình ảnh trên Wikimedia Commons
