โมเดลถอดเสียงเปิดน้ำหนักมาแล้วอย่างเงียบ ๆ — และมีขนาดแค่ 1.56 GB
โมเดล Qwen3-ASR ของอาลีบาบาใช้สัญญาอนุญาต Apache 2.0 รองรับ 52 ภาษาและสำเนียง และดาวน์โหลดไม่ถึงสองกิกะไบต์ คู่มือภาษาง่าย ๆ ว่าด้วยชั้นถอดเสียงแบบเปิดน้ำหนัก มีอะไรให้ใช้บ้าง การรันโมเดลบนโน้ตบุ๊กของคุณเองได้อะไรจริง ๆ และ API แบบปิดยังชนะตรงไหน
ตอนนี้คุณรันระบบรู้จำเสียงพูดแบบเปิดน้ำหนักบนแล็ปท็อปได้แล้ว: ทีม Qwen ของอาลีบาบาเผยแพร่ Qwen3-ASR-0.6B, Qwen3-ASR-1.7B และโมเดลคู่กัน Qwen3-ForcedAligner-0.6B ภายใต้สัญญาอนุญาต Apache 2.0 รุ่นดาวน์โหลดเล็กที่สุดมีขนาด 1.56 GB รองรับ 52 ภาษาและสำเนียง และตั้งแต่ 26 มิถุนายนก็รันได้ด้วย Python มาตรฐานสามบรรทัด การรันบนเครื่องของคุณเองช่วยเลี่ยงค่าถอดเสียงที่คิดตามคำขอแต่ละครั้ง
การเปลี่ยนแปลงนี้คงคุ้นสำหรับคนที่ติดตามโมเดลภาษาแบบเปิด: การโฮสต์เองให้การควบคุมต้นทุน ความเป็นส่วนตัว และการใช้งานออฟไลน์มากกว่า ขณะที่ API แบบโฮสต์ยังใช้งานง่ายกว่า ระบบรู้จำเสียงพูดกำลังมาถึงทางเลือกแบบเดียวกัน โดยมีโมเดลที่เล็กพอจะรันในเครื่องได้
คู่มือนี้อธิบายว่าระบบรู้จำเสียงพูดแบบเปิดน้ำหนักทำอะไรได้บ้าง โมเดลและสัญญาอนุญาตที่มีต่างกันอย่างไร โมเดลขนาดเล็กรันบนอุปกรณ์ใดได้ และ API แบบโฮสต์ยังได้เปรียบตรงไหน
TL;DR:
- การถอดเสียงด้วยโมเดลเปิดน้ำหนักใช้งานได้จริงแล้ววันนี้ Qwen3-ASR อยู่ใต้ Apache 2.0 รองรับ 52 ภาษาและสำเนียง, Whisper อยู่ใต้ MIT, Parakeet และ Canary ของ NVIDIA อยู่ใต้ CC BY 4.0, Voxtral ของ Mistral อยู่ใต้ Apache 2.0
- การโฮสต์เองให้ความเป็นส่วนตัว การทำงานออฟไลน์ และการคุมต้นทุน บนกระดานอิสระของ Artificial Analysis การโฮสต์โมเดลเปิดตกที่ 1.50 ดอลลาร์ต่อ 1,000 นาที เทียบกับ 6.00 ดอลลาร์ของ MAI-Transcribe-1.5 จากไมโครซอฟท์ และ 18.15 ดอลลาร์ของ Gemini 3.1 Pro Preview
- อันดับหนึ่งด้านความแม่นยำยังเป็นปลายทางแบบพรีวิวที่ปิดอยู่ แต่โมเดลเปิดภายใต้ Apache 2.0 อย่าง Voxtral Small ขึ้นมาอยู่อันดับห้าแล้ว ห่างจากอันดับหนึ่งราวหนึ่งจุดของอัตราผิดพลาดระดับคำ
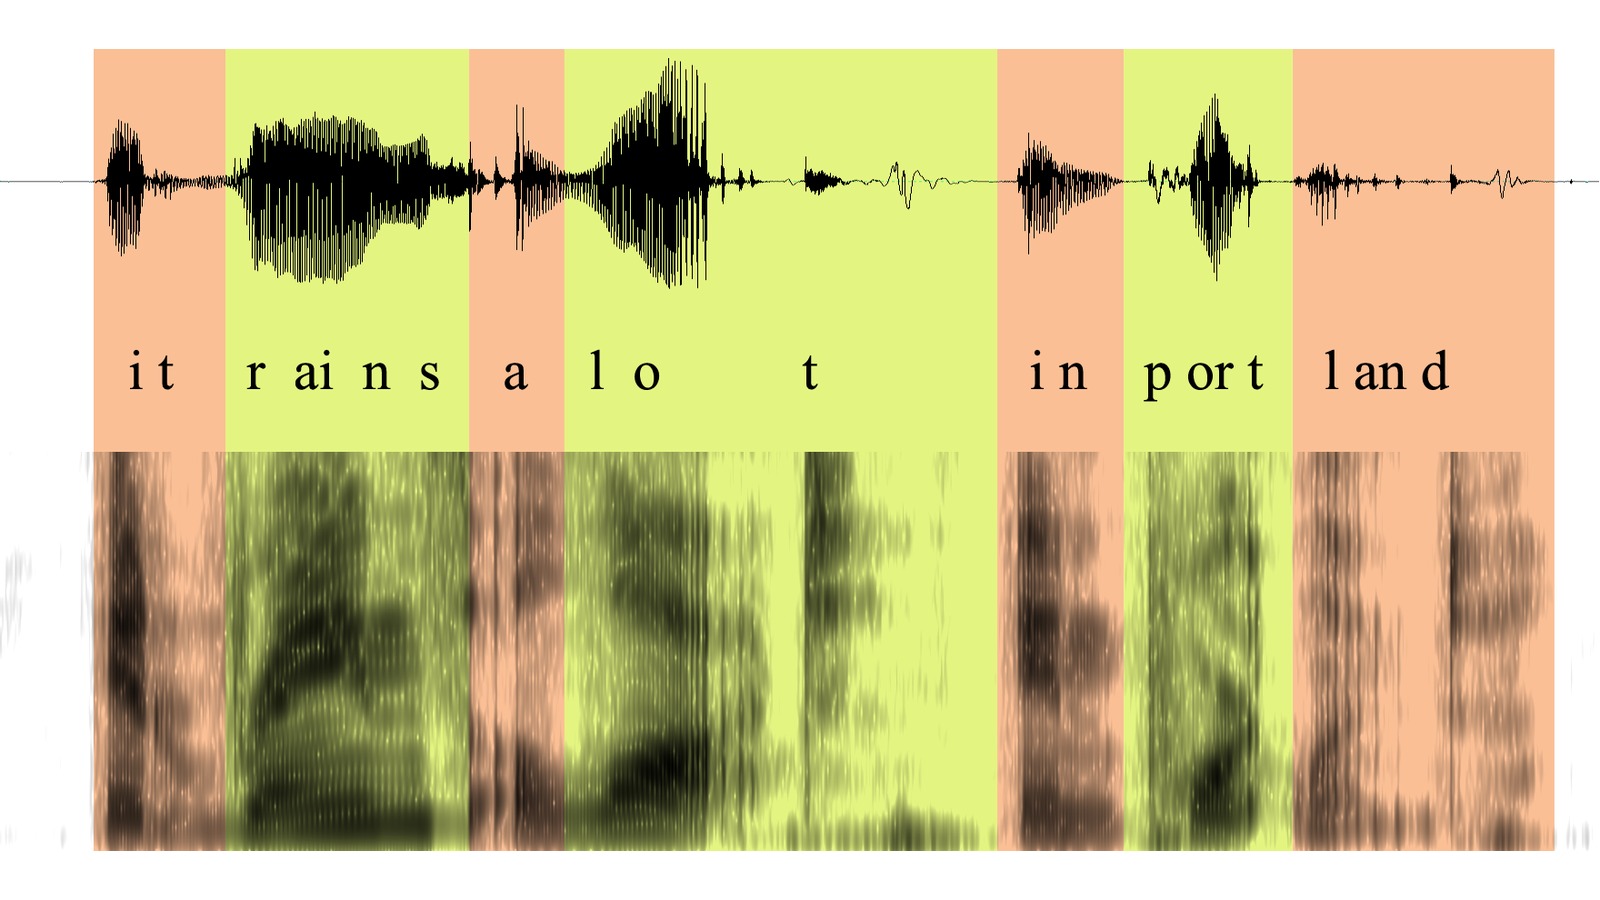
ภาพ: Aaron Parecki, Wikimedia Commons, CC BY 2.0 รูปคลื่นเสียงและสเปกโตรแกรมของประโยค "it rains a lot in Portland" โดยตัวอักษรถูกวางไว้เหนือช่วงเสียงที่ตรงกัน นี่คือวัตถุดิบตั้งต้นที่โมเดลรู้จำเสียงพูดทุกตัวต้องทำงานด้วย
คุณดาวน์โหลดอะไรกันแน่ตอนที่ดาวน์โหลดโมเดลถอดเสียง
โมเดล ASR หรือการรู้จำเสียงพูดอัตโนมัติ ซึ่งใช้แทนกันได้กับ STT หรือการแปลงเสียงเป็นข้อความ คือโปรแกรมที่รับเสียงเข้าไปแล้วผลิตข้อความออกมา งานมีแค่นั้น มันไม่ตัดสินว่าใครพูด ไม่สรุปให้ ไม่รู้ว่าการประชุมของคุณว่าด้วยเรื่องอะไร มันได้ยินคำแล้วก็เขียนลงไป
"เปิดน้ำหนัก" หมายความว่าห้องแล็บเผยแพร่ไฟล์โมเดลที่เสร็จสมบูรณ์ออกมาเลย น้ำหนักของโมเดลคือตารางตัวเลขมหึมาที่มันเรียนรู้มาระหว่างการฝึก และการเผยแพร่มันหมายความว่าคุณดาวน์โหลดไฟล์นั้น รันบนฮาร์ดแวร์ของตัวเอง แล้วสร้างต่อยอดได้โดยไม่ต้องขออนุญาตใครและไม่ต้องจ่ายรายครั้ง อีกทางเลือกคือโมเดลแบบปิด น้ำหนักอยู่บนเซิร์ฟเวอร์ของผู้ให้บริการ ส่วนคุณเช่าสิทธิ์เข้าถึงผ่าน API เสียงส่งขึ้นไป ข้อความส่งกลับมา และคิดเงินเป็นรายนาที
ตัวเลขในชื่อคือจำนวนพารามิเตอร์ และสำหรับโมเดลเสียงตัวเลขนี้จับต้องได้มากผิดปกติ "0.6B" หมายถึงพารามิเตอร์ราว 600 ล้านตัว ซึ่งในทางปฏิบัติทำให้ Qwen3-ASR-0.6B เป็นไฟล์ขนาด 1.56 GB และ Qwen3-ASR-1.7B ขนาด 4.08 GB ทั้งคู่เล็กพอจะนอนอยู่บน SSD ของโน้ตบุ๊กโดยไม่มีใครสังเกต ลองเทียบกับโมเดลภาษาแบบเปิดที่เราเขียนถึงในบทสรุปคลื่นโมเดลเปิดของจีน ซึ่งตัวชูโรงมีขนาด 1.56 เทระไบต์แบ่งเป็น 96 ชิ้น และต้องใช้คลัสเตอร์แค่จะโหลดขึ้นมา โมเดลเสียงเล็กกว่าโมเดลข้อความระดับแนวหน้าราวพันเท่า และข้อเท็จจริงข้อเดียวนี้เองที่ทำให้ความเปลี่ยนแปลงรอบนี้กระทบแรงกว่ารอบก่อน
เรียกช่วงขนาดนี้ว่า ระดับแล็ปท็อป: โมเดลเล็กพอที่การลองใช้เป็นแค่เรื่องดาวน์โหลด ไม่ใช่การตัดสินใจเรื่องงบฮาร์ดแวร์ โมเดลข้อความระดับแนวหน้าส่วนใหญ่ยังอยู่นอกกลุ่มนี้ ส่วนโมเดลเสียงจำนวนมากอยู่ในกลุ่มนี้
ตรวจสัญญาอนุญาตก่อนเลือกใช้โมเดล Apache 2.0 และ MIT อนุญาตให้ใช้ แก้ไข และเผยแพร่เชิงพาณิชย์ได้ ส่วน CC BY 4.0 ซึ่งใช้กับโมเดลของ NVIDIA ก็อนุญาตให้ใช้เชิงพาณิชย์เช่นกัน แต่ต้องระบุที่มา
Qwen ปล่อยตระกูลนี้ตั้งแต่มกราคม เดือนมิถุนายนคือตอนที่มันง่ายขึ้น
Qwen3-ASR เปิดตัวครั้งแรกเมื่อ 28 มกราคม 2026 และรายงานทางเทคนิคเผยแพร่บน arXiv ในวันถัดมา เมื่อ 26 มิถุนายน Qwen เผยแพร่รุ่น -hf ของทั้งสามโมเดล ซึ่งเข้ากันได้กับ Hugging Face Transformers ตั้งแต่เวอร์ชัน 5.13.0 เป็นต้นไป
การเปลี่ยนบรรจุภัณฑ์ทำให้การตั้งค่าเป็นสิ่งที่คุ้นเคยขึ้น: แทนที่จะติดตั้งแพ็กเกจ qwen-asr ของ Qwen หรือแบ็กเอนด์ vLLM นักพัฒนาที่ใช้ Transformers สามารถโหลดเช็กพอยต์ -hf ด้วย Python มาตรฐานได้ ช่วยลดภาระการตั้งค่าโดยไม่เปลี่ยนสิ่งที่โมเดลรู้จำได้
การ์ดโมเดลระบุว่ารู้จำภาษาและเสียงพูดได้ 30 ภาษา ได้แก่ อังกฤษ จีน เกาหลี ญี่ปุ่น สเปน อาหรับ ฮินดี ไทย เวียดนาม โปแลนด์ และอีก 20 ภาษา พร้อมสำเนียงจีนอีก 22 สำเนียง รวมเป็น 52 ภาษาและสำเนียง ทั้งสองขนาดรองรับการอนุมานแบบสตรีมและออฟไลน์ด้วยโมเดลเดียว รับเสียงยาวได้ และระบุเสียงร้องกับเพลงที่มีดนตรีประกอบเป็นประเภทเสียงที่รองรับ
Qwen3-ForcedAligner-0.6B เพิ่มความสามารถในการจัดแนวแบบบังคับ: เมื่อมีเสียงและข้อความถอดเสียง โมเดลจะระบุเวลาเริ่มและจบของแต่ละคำได้ละเอียดถึงระดับมิลลิวินาที รองรับ 11 ภาษาและคลิปยาวได้สูงสุดห้านาที จึงทำข้อความถอดเสียงที่คลิกได้ ตั้งเวลาให้คำบรรยาย และข้ามไปยังช่วงที่พูดคำนั้นได้ การเผยแพร่ตัวจัดแนวพร้อมตัวรู้จำทำให้ตระกูลนี้เหมาะกับการสร้างผลิตภัณฑ์ถอดเสียง ไม่ใช่แค่รันเดโม
การ์ดโมเดลของ Qwen รายงานผลจาก Hugging Face Open ASR Leaderboard ณ วันที่ 26 มิถุนายน 2026: อัตราความผิดพลาดของคำเฉลี่ยอยู่ที่ 5.59% สำหรับรุ่น 1.7B และ 6.31% สำหรับรุ่น 0.6B; ในชุดเสียงประชุม AMI ตัวเลขคือ 9.26% และ 10.57% อัตราความผิดพลาดของคำที่ต่ำกว่าหมายถึงมีคำที่รู้จำผิดน้อยกว่า Qwen ระบุว่ารุ่น 1.7B ล้ำหน้าที่สุดในกลุ่ม ASR แบบเปิดและแข่งขันกับ API เชิงพาณิชย์ได้ ซึ่งเป็นผลที่ผู้ให้บริการรายงานเอง กระดานอิสระด้านล่างใช้เสียงคนละชุด คะแนนจึงเปรียบเทียบกันโดยตรงไม่ได้
Whisper เป็นผู้เริ่มเรื่องนี้ และยังเป็นโมเดลที่ทุกคนรัน
ทั้งหมดนี้คงไม่มีรูปร่างแบบทุกวันนี้ถ้าไม่มี Whisper ของ OpenAI คลังโค้ดเปิดสาธารณะเมื่อ 16 กันยายน 2022 ภายใต้สัญญาอนุญาต MIT ทั้งโค้ดและน้ำหนัก ในช่วงเวลาที่การรู้จำเสียงพูดอย่างจริงจังหมายถึงการทำสัญญากับผู้ให้บริการคลาวด์ ตั้งแต่นั้นมามันสะสมดาวบน GitHub ได้ 106,679 ดวง
สิ่งที่ทำให้ Whisper สำคัญไม่ใช่ตัวโมเดลเท่ากับสิ่งที่ชุมชนสร้างต่อยอดบนมันภายในไม่กี่เดือน whisper.cpp เขียนมันขึ้นใหม่ด้วย C และ C++ ล้วน สัญญาอนุญาต MIT ดาว 52,591 ดวง และทำให้มันรันบนโน้ตบุ๊กกับโทรศัพท์ได้โดยไม่ต้องมี Python และไม่ต้องมี GPU ส่วน faster-whisper สร้างมันใหม่บน CTranslate2 ได้ความเร็วและหน่วยความจำดีขึ้นมาก เป็น MIT เช่นกัน ดาว 24,750 ดวง โมเดลคือเมล็ด ระบบนิเวศคือต้นไม้
สี่ปีต่อมา Whisper ยังคงถูกใช้อย่างแพร่หลาย ในช่วง 30 วันก่อนวันที่ 5 สิงหาคม 2026 whisper-large-v3-turbo ถูกดาวน์โหลดจาก Hugging Face 8.72 ล้านครั้ง และ whisper-large-v3 5.50 ล้านครั้ง; Qwen3-ASR-0.6B ทำได้ 4.29 ล้านครั้ง บนกระดาน Artificial Analysis Whisper Large v3 ได้คะแนน AA-WER 4.07% เทียบกับ 1.73% ของโมเดลนำในภาพข้อมูลชุดนั้น
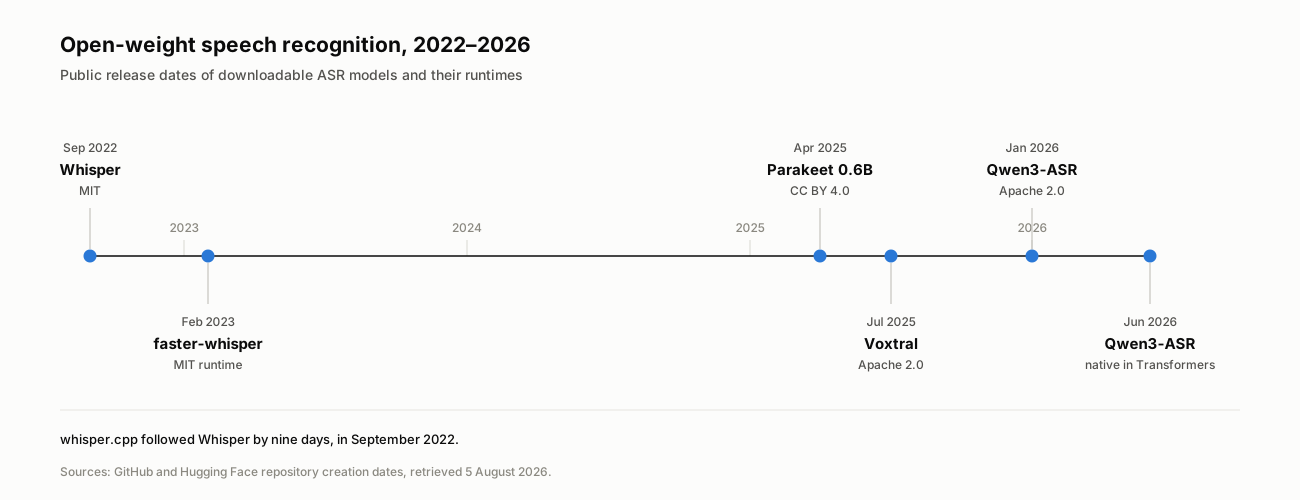
ชั้นเสียงพูดแบบเปิดมาเป็นสองระลอกห่างกันสามปี และระหว่างนั้นแทบว่างเปล่า วันที่เปิดตัวจาก GitHub และ Hugging Face ดึงข้อมูลเมื่อ 5 สิงหาคม 2026
ฝั่งเปิดไม่ได้มีแค่ห้องแล็บเดียว
Qwen ไม่ได้อยู่ลำพัง และรายอื่นเก่งคนละเรื่องกันชัดเจน
สาย Parakeet ของ NVIDIA เน้นความเร็ว parakeet-tdt-0.6b-v3 ซึ่งเผยแพร่ในเดือนสิงหาคม 2025 ภายใต้ CC BY 4.0 มี 600 ล้านพารามิเตอร์ รองรับ 25 ภาษายุโรป และมีการตรวจจับภาษาอัตโนมัติ เครื่องหมายวรรคตอน การใช้ตัวพิมพ์ใหญ่ และเวลาประทับระดับคำ สำหรับเสียงยาวสูงสุด 24 นาทีต่อรอบ ตระกูล Canary ของ NVIDIA — canary-1b-v2 และ canary-qwen-2.5b ซึ่งใช้ CC BY 4.0 เช่นกัน — มีความสามารถใกล้เคียงกัน โมเดล Voxtral ของ Mistral ซึ่งเผยแพร่ในเดือนกรกฎาคม 2025 ภายใต้ Apache 2.0 อยู่ใกล้กลุ่มบนของการเปรียบเทียบอิสระด้านล่าง
นี่คือฝั่งเปิดวางเรียงข้างกัน โดยแถวสุดท้ายเป็น API แบบโฮสต์ไว้เทียบให้เห็นความต่าง
| โมเดล | ขนาดดาวน์โหลด | สัญญาอนุญาต | ภาษา | รันที่ไหน | เก่งที่สุดเรื่อง |
|---|---|---|---|---|---|
| Whisper Large v3 | 3.09 GB | MIT | 99 | โน้ตบุ๊กหรือ GPU หนึ่งตัว | เป็นค่าตั้งต้นที่เครื่องมือทุกตัวรองรับอยู่แล้ว |
| Qwen3-ASR-0.6B | 1.56 GB | Apache 2.0 | 52 รวมสำเนียง | โน้ตบุ๊ก | งานหลายภาษาในขนาดเล็กที่สุด |
| Qwen3-ASR-1.7B | 4.08 GB | Apache 2.0 | 52 รวมสำเนียง | โน้ตบุ๊กหรือ GPU หนึ่งตัว | ความแม่นยำสูงสุดในตระกูล Qwen |
| Parakeet TDT 0.6B v3 | 2.51 GB | CC BY 4.0 | ยุโรป 25 | โน้ตบุ๊กหรือ GPU หนึ่งตัว | ความเร็วและเวลาประทับระดับคำ |
| Voxtral Small | — | Apache 2.0 | — | GPU ระดับเซิร์ฟเวอร์ 2.4 หมื่นล้านพารามิเตอร์ | คะแนนสูงสุดของโมเดลเปิดบนกระดานอิสระ |
| API แบบโฮสต์ | ดาวน์โหลดไม่ได้ | ปิด | แล้วแต่เจ้า | คลาวด์ของผู้ให้บริการ | แยกผู้พูด สตรีมมิ่ง และความพร้อมใช้งาน |
ขนาดดาวน์โหลดคือเช็กพอยต์เริ่มต้นในแต่ละคลัง Hugging Face ส่วน "—" หมายถึงเอกสารต้นทางที่ใช้เปรียบเทียบนี้ไม่ได้ระบุค่าไว้ ภาพข้อมูลดึงมาเมื่อ 5 สิงหาคม 2026
ถัดจากนั้นคืองานห่อหุ้มที่พาโมเดลเหล่านี้ขึ้นไปอยู่บนอุปกรณ์จริง ซึ่งเป็นจุดที่ชั้นโน้ตบุ๊กเลิกเป็นเรื่องบนกระดาษ whisperkit-coreml ซึ่งคือ Whisper ที่คอมไพล์สำหรับฮาร์ดแวร์แอปเปิล ถูกดาวน์โหลด 8.31 ล้านครั้งในรอบ 30 วันที่ผ่านมา บิลด์ MLX ของ Parakeet สำหรับ Apple Silicon ได้ไป 1.87 ล้านครั้ง และไฟล์แปลง GGUF สองตัว ซึ่งเป็นรูปแบบบีบข้อมูลที่ทำให้โมเดลรันบนซีพียูธรรมดาได้ ทำได้ 2.04 ล้านและ 1.87 ล้านครั้ง แต่ละเดือนมีคนหลายล้านคนดาวน์โหลดระบบรู้จำเสียงพูดที่ถูกห่อมาเพื่อรันบนเครื่องของตัวเองโดยเฉพาะ นี่ไม่ใช่ของแปลกในวงวิจัย นี่คือช่องทางจัดจำหน่าย
อันดับหนึ่งยังเป็นปลายทางแบบพรีวิวที่คุณดาวน์โหลดไม่ได้
การเปรียบเทียบนี้แยกความแม่นยำในการรู้จำออกจากข้อดีด้านการปฏิบัติงานของการรันโมเดลเอง
กระดานแปลงเสียงเป็นข้อความของ Artificial Analysis ซึ่งดึงข้อมูลเมื่อ 5 สิงหาคม 2026 วัดโมเดลแบบเปิดและแบบปิดด้วยเสียงชุดเดียวกัน ผล AA-WER v2 มีดังนี้:
| อันดับ | โมเดล | AA-WER | ดาวน์โหลดได้ไหม |
|---|---|---|---|
| 1 | Fun-Realtime-ASR-preview | 1.73% | ไม่ได้ — ปลายทางแบบพรีวิว |
| 2 | Scribe v2, ElevenLabs | 2.18% | ไม่ได้ — API แบบโฮสต์ |
| 3 | MAI-Transcribe-1.5, ไมโครซอฟท์ | 2.38% | ไม่ได้ — API แบบโฮสต์ |
| 4 | Smallest AI Pulse Pro | 2.43% | ไม่ได้ — API แบบโฮสต์ |
| 5 | Voxtral Small, Mistral | 2.77% | ได้ — Apache 2.0 |
| 6 | Gemini 3.1 Pro Preview, High | 2.82% | ไม่ได้ — API แบบโฮสต์ |
| 11 | Whisper Large v3 | 4.07% | ได้ — MIT |
ที่มา: กระดานแปลงเสียงเป็นข้อความของ Artificial Analysis, AA-WER v2, ดึงข้อมูลเมื่อ 5 สิงหาคม 2026 สถานะการดาวน์โหลดประเมินจากสัญญาอนุญาตที่แต่ละโมเดลเผยแพร่
สี่แถวแรกแสดงให้เห็นว่าโมเดลคะแนนสูงสุดในภาพข้อมูลชุดนี้เป็นบริการแบบโฮสต์ และตัวนำเป็นปลายทางพรีวิว ไม่ใช่โมเดลที่ดาวน์โหลดได้
Voxtral Small ใช้ Apache 2.0 และอยู่อันดับห้าด้วยคะแนน 2.77% ตามหลังโมเดลพรีวิวแบบปิดที่นำอยู่ราวหนึ่งจุดเปอร์เซ็นต์ สำหรับการประชุมหนึ่งชั่วโมงที่มี 6,300 คำ ความต่างนี้เทียบได้กับประมาณ 66 คำ เป็นช่องว่างที่มีอยู่จริง แต่ไม่ใช่สิ่งที่ทีมซึ่งให้ความสำคัญกับการติดตั้งใช้งานในเครื่องจะก้าวข้ามไม่ได้
สำหรับงานจำนวนมาก โมเดลเสียงแบบเปิดใช้งานได้ดีอยู่แล้ว ทางเลือกที่เหลือคือช่องว่างด้านความแม่นยำระดับพอประมาณคุ้มกับการควบคุมจากการโฮสต์เองหรือไม่ หรือฟีเจอร์รอบบริการแบบโฮสต์คุ้มกับค่าใช้จ่ายมากกว่า
รันเองแล้วได้อะไร และต้องจ่ายอะไร
มีสามอย่างที่ผลักทีมงานไปทางการโฮสต์เอง และไม่มีข้อไหนเป็นเรื่องความแม่นยำ
ข้อแรกคือความเป็นส่วนตัว และมักเป็นตัวตัดสิน ถ้าคุณถอดเสียงการปรึกษาแพทย์ การสัมภาษณ์ทางกฎหมาย หรือการพูดคุยเรื่องบุคลากร คำว่า "เสียงไม่ออกจากฮาร์ดแวร์ของเรา" ไม่ใช่ความชอบส่วนตัวแต่เป็นข้อกำหนดในการจัดซื้อ และโมเดลที่คุณโฮสต์เองคือสถาปัตยกรรมเดียวที่ตอบโจทย์นั้นได้อย่างสะอาด ข้อที่สองคือการทำงานออฟไลน์ โมเดลที่อยู่บนเครื่องทำงานได้บนเครื่องบิน ในห้องใต้ดิน บนพื้นโรงงาน ที่หน้างานซึ่งไม่มีสัญญาณ นี่แหละคือเหตุผลที่ whisper.cpp และบิลด์ GGUF มียอดดาวน์โหลดอย่างที่เห็น
ข้อที่สามคือต้นทุน และตัวเลขตรงนี้ค่อนข้างโหด จากภาพรวมชุดเดียวกันของ Artificial Analysis ราคาต่อเสียง 1,000 นาที Whisper Large v3 ที่โฮสต์บน fal.ai อยู่ที่ 0.50 ดอลลาร์ Canary Qwen 2.5B ของ NVIDIA บน Replicate อยู่ที่ 0.74 ดอลลาร์ และ Parakeet TDT 0.6B V3 บน Together AI อยู่ที่ 1.50 ดอลลาร์ ส่วนฝั่งปิด Nova-3 ของ Deepgram อยู่ที่ 4.30 ดอลลาร์ MAI-Transcribe-1.5 อยู่ที่ 6.00 ดอลลาร์ และ Gemini 3.1 Pro Preview อยู่ที่ 18.15 ดอลลาร์ นั่นคือห่างกัน 4 เท่าเมื่อเทียบกับไมโครซอฟท์และ 12 เท่าเมื่อเทียบกับกูเกิล เพียงแค่การโฮสต์โมเดลเปิดไว้บนเซิร์ฟเวอร์ของคนอื่น ยังไม่นับกรณีรันบนเครื่องตัวเอง ซึ่งต้นทุนส่วนเพิ่มของชั่วโมงที่หนึ่งพันคือค่าไฟ
ตัวเลขความเร็วในภาพข้อมูลชุดเดียวกันให้ Parakeet TDT 0.6B V3 ที่ให้บริการบน Together AI นำอยู่ที่ 885 เท่าของเวลาจริง — ประมวลผลเสียงหนึ่งชั่วโมงได้ในประมาณสี่วินาที Nova-3 ของ Deepgram ทำได้ 512 เท่า Whisper Large v3 บน Together ทำได้ 478 เท่า และ MAI-Transcribe-1.5 ทำได้ 189 เท่า ตัวเลือกที่เร็วที่สุดในรายการเป็นโมเดลเปิดน้ำหนัก แต่ผลนี้วัดการโฮสต์บน Together AI ไม่ใช่ฮาร์ดแวร์ในเครื่อง
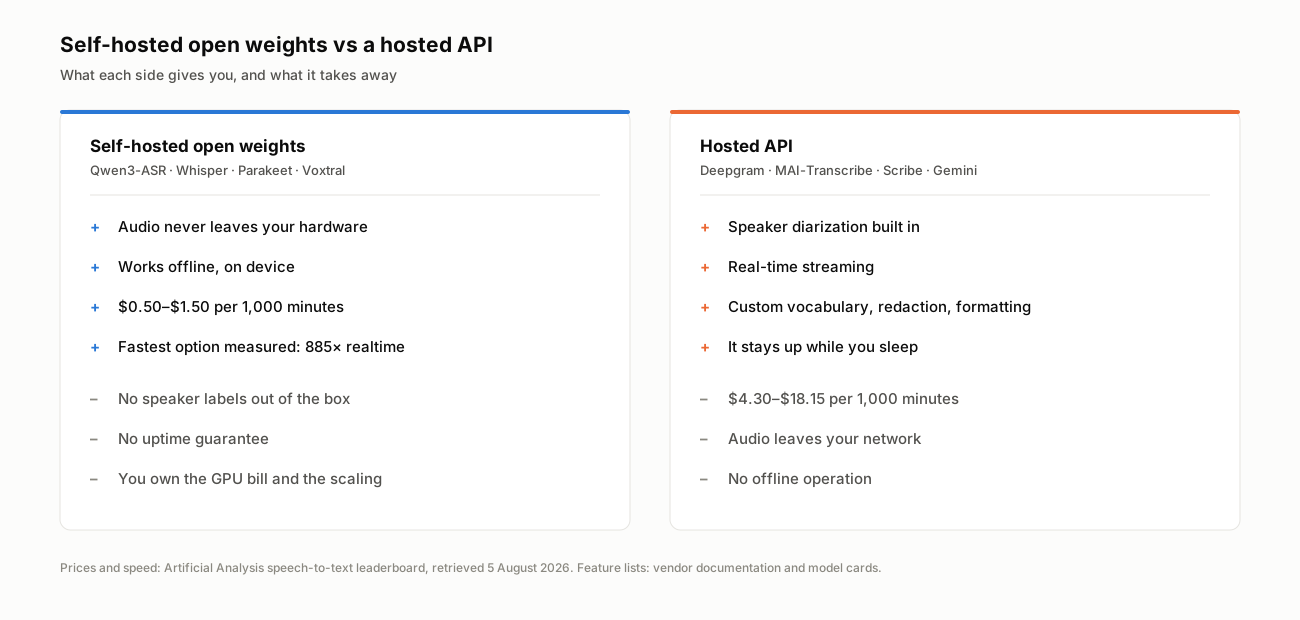
การแลกเปลี่ยนนี้ไม่เคยเป็นเรื่องความแม่นยำปะทะความแม่นยำ แต่เป็นการควบคุมกับต้นทุน ปะทะฟีเจอร์ที่ห่อหุ้มการรู้จำเสียงเอาไว้
แล้ว API แบบโฮสต์ขายอะไรอยู่ ก็ขายทุกอย่างที่ไม่ใช่การรู้จำเสียง เอกสารของ Deepgram คือบัญชีรายการที่ตรงไปตรงมา ได้แก่ การแยกผู้พูด การสตรีมแบบเรียลไทม์ การจัดรูปแบบ คำศัพท์เฉพาะ การปิดบังข้อมูลระบุตัวตน การตรวจจับภาษา และการรับประกันเชิงปฏิบัติการว่าบริการยังทำงานอยู่ตอนที่คุณหลับ ดาวน์โหลด Qwen3-ASR มาแล้วคุณจะได้คำกับเวลาประทับ ไม่มีป้ายชื่อผู้พูด ไม่มี SLA และค่า GPU การขยายขนาด กับสายเรียกตอนตีสามเป็นของคุณเอง
โมเดลที่ถูกดาวน์โหลดมากที่สุดในหมวดนี้ไม่ใช่โมเดลถอดเสียง
รูปแบบการดาวน์โหลดก็แสดงให้เห็นความต้องการระบุผู้พูดควบคู่ไปกับการถอดเสียง
เมื่อเรียงหมวดการรู้จำเสียงพูดอัตโนมัติทั้งหมดบน Hugging Face ตามยอดดาวน์โหลด โมเดลที่อยู่บนสุดไม่ใช่ Whisper ไม่ใช่ Qwen และไม่ใช่ Parakeet แต่เป็น pyannote/speaker-diarization-3.1 ด้วยยอด 8.91 ล้านครั้งในรอบ 30 วันที่ผ่านมา และโมเดลแยกผู้พูดอีกตัวของ pyannote อยู่อันดับห้าด้วยยอด 5.26 ล้านครั้ง การแยกผู้พูดคือกลไกที่หาคำตอบว่าใครพูดตอนไหน ซึ่งก็คือชั้นที่อยู่เหนือการถอดเสียงขึ้นไปหนึ่งชั้นพอดี
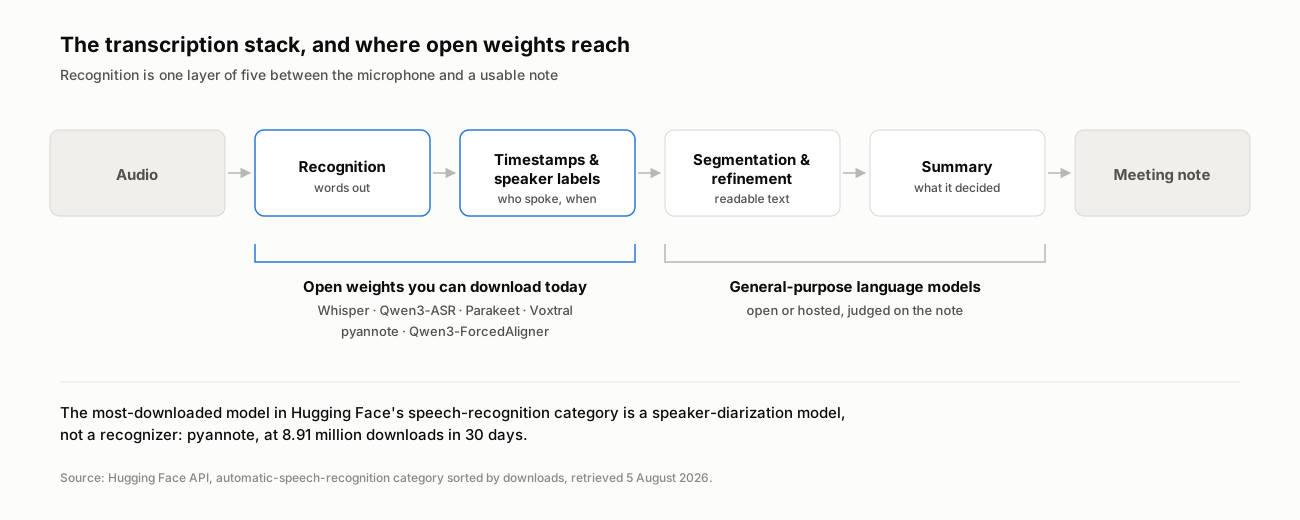
ตอนนี้โมเดลเปิดครอบคลุมสองชั้นล่างสุดแล้ว ส่วนชั้นที่ตัดสินว่าบันทึกนั้นใช้ได้จริงหรือไม่อยู่เหนือขึ้นไป
โมเดลที่ถูกดาวน์โหลดมากที่สุดในหมวดรู้จำเสียงพูดไม่ได้รู้จำคำพูด แต่มันระบุว่าใครพูดเมื่อไร ความต้องการนี้ชี้ไปยังชั้นที่อยู่เหนือการถอดเสียง ซึ่งป้ายกำกับผู้พูดช่วยเปลี่ยนคำที่รู้จำได้ให้กลายเป็นบันทึกการประชุมที่มีประโยชน์ สอดคล้องกับช่องว่างของผลิตภัณฑ์ที่อธิบายไว้ในบทวิเคราะห์ตลาดแบบปิดของเรา
สรุป
คำถามที่น่าสนใจเกี่ยวกับการรู้จำเสียงพูดแบบเปิดน้ำหนักไม่เคยเป็น "มันดีเท่าโมเดลปิดหรือยัง" มันห่างอยู่ราวหนึ่งจุดของอัตราผิดพลาดระดับคำ มันเร็วกว่า มันถูกกว่าสี่ถึงสิบสองเท่า และมันใส่ลงโน้ตบุ๊กได้ คำถามที่น่าสนใจคือคุณจะสร้างอะไรในพื้นที่ที่เปิดออกเมื่อการถอดเสียงเลิกเป็นรายจ่ายที่ต้องเช่า เพราะไฟล์ขนาด 1.56 GB ที่ฟังออก 52 ภาษาไม่ใช่ผลิตภัณฑ์ มันคือชิ้นส่วนที่เพิ่งกลายเป็นของฟรี
สำหรับทีมที่กำลังเลือกเครื่องมือจดบันทึกการประชุมแทนที่จะเลือกโมเดล สิ่งที่ต้องอ่านนั้นสั้น การที่ผลิตภัณฑ์หนึ่งรันโมเดลเปิดหรือ API ปิดตอนนี้ส่วนใหญ่เป็นแค่รายละเอียดการติดตั้ง และนับวันจะเป็นทั้งสองอย่าง คือใช้น้ำหนักเปิดกับงานปริมาณมาก และใช้ API แบบโฮสต์ตรงที่การแยกผู้พูด การสตรีม และการรองรับสเกลคุ้มกับราคา Telli.sh รันโมเดลเปิดในชั้นสรุปอยู่แล้ว ความก้าวหน้าของฝั่งเปิดจึงไหลตรงเข้าสู่การถอดเสียง การแปล และบันทึกการประชุมโดยไม่ขึ้นราคา ตัดสินเครื่องมือจากสิ่งที่ออกมาตอนท้าย ว่าบันทึกนั้นบอกคุณหรือไม่ว่าใครรับปากจะทำอะไร
แหล่งอ้างอิง
- การ์ดโมเดล Qwen3-ASR-0.6B-hf (Hugging Face) — สัญญาอนุญาต รายชื่อภาษา และตัวเลขกระดานลงวันที่ 26 มิถุนายน 2026
- การ์ดโมเดล Qwen3-ASR-1.7B-hf (Hugging Face)
- Qwen3-ForcedAligner-0.6B (Hugging Face)
- Qwen3-ASR Technical Report, arXiv:2601.21337 (ส่งเมื่อ 29 มกราคม 2026)
- คลังโค้ด OpenAI Whisper (MIT, เผยแพร่ 16 กันยายน 2022)
- whisper.cpp และ faster-whisper
- การ์ดโมเดล NVIDIA parakeet-tdt-0.6b-v3 (CC BY 4.0)
- Mistral Voxtral-Small-24B-2507 (Apache 2.0)
- กระดานแปลงเสียงเป็นข้อความของ Artificial Analysis — AA-WER v2 ตัวเลขความเร็วและราคาดึงเมื่อ 5 สิงหาคม 2026
- Hugging Face Open ASR Leaderboard
- เอกสาร Deepgram เรื่องการแยกผู้พูด
- หน้าภาพบน Wikimedia Commons
