Pengenalan suara diam-diam jadi open weight — dan muat dalam 1,56 GB
Model Qwen3-ASR dari Alibaba berlisensi Apache 2.0, mencakup 52 bahasa dan dialek, serta berukuran unduhan di bawah dua gigabyte. Panduan bahasa sederhana tentang lapisan transkripsi open weight: apa saja yang tersedia, apa yang sebenarnya Anda dapat dari menjalankan model di laptop sendiri, dan di mana API tertutup masih unggul.
Anda kini dapat menjalankan pengenalan suara berbobot terbuka di laptop: tim Qwen dari Alibaba menerbitkan Qwen3-ASR-0.6B, Qwen3-ASR-1.7B, dan Qwen3-ForcedAligner-0.6B sebagai pendamping, di bawah Apache 2.0. Unduhan terkecil berukuran 1,56 GB, mendukung 52 bahasa dan dialek, serta sejak 26 Juni dapat dijalankan dengan tiga baris Python standar. Menjalankannya sendiri menghindari biaya transkripsi per permintaan.
Perubahan ini terasa akrab bagi siapa pun yang mengikuti model bahasa terbuka: menjalankan model sendiri memberi kendali lebih besar atas biaya, privasi, dan penggunaan luring, sementara API terhosting lebih mudah dioperasikan. Pengenalan suara kini berkembang dengan pilihan yang sama, dengan model yang cukup kecil untuk dijalankan secara lokal.
Panduan ini menjelaskan fungsi pengenalan suara berbobot terbuka, perbedaan model dan lisensinya, apa yang dapat dijalankan pada laptop, serta keunggulan yang masih dimiliki API terhosting.
TL;DR:
- Transkripsi open weight sudah bisa dipakai hari ini: Qwen3-ASR dengan Apache 2.0 dan 52 bahasa serta dialek, Whisper dengan MIT, Parakeet dan Canary dari NVIDIA dengan CC BY 4.0, Voxtral dari Mistral dengan Apache 2.0.
- Menghosting sendiri memberi privasi, operasi luring, dan kendali biaya. Di papan independen Artificial Analysis, menghosting model terbuka berbiaya 1,50 dolar per 1.000 menit, berbanding 6,00 dolar untuk MAI-Transcribe-1.5 dari Microsoft dan 18,15 dolar untuk Gemini 3.1 Pro Preview.
- Peringkat satu untuk akurasi masih dipegang endpoint pratinjau tertutup. Namun satu model terbuka berlisensi Apache 2.0, Voxtral Small, kini duduk di peringkat lima, sekitar satu poin tingkat kesalahan kata di belakangnya.
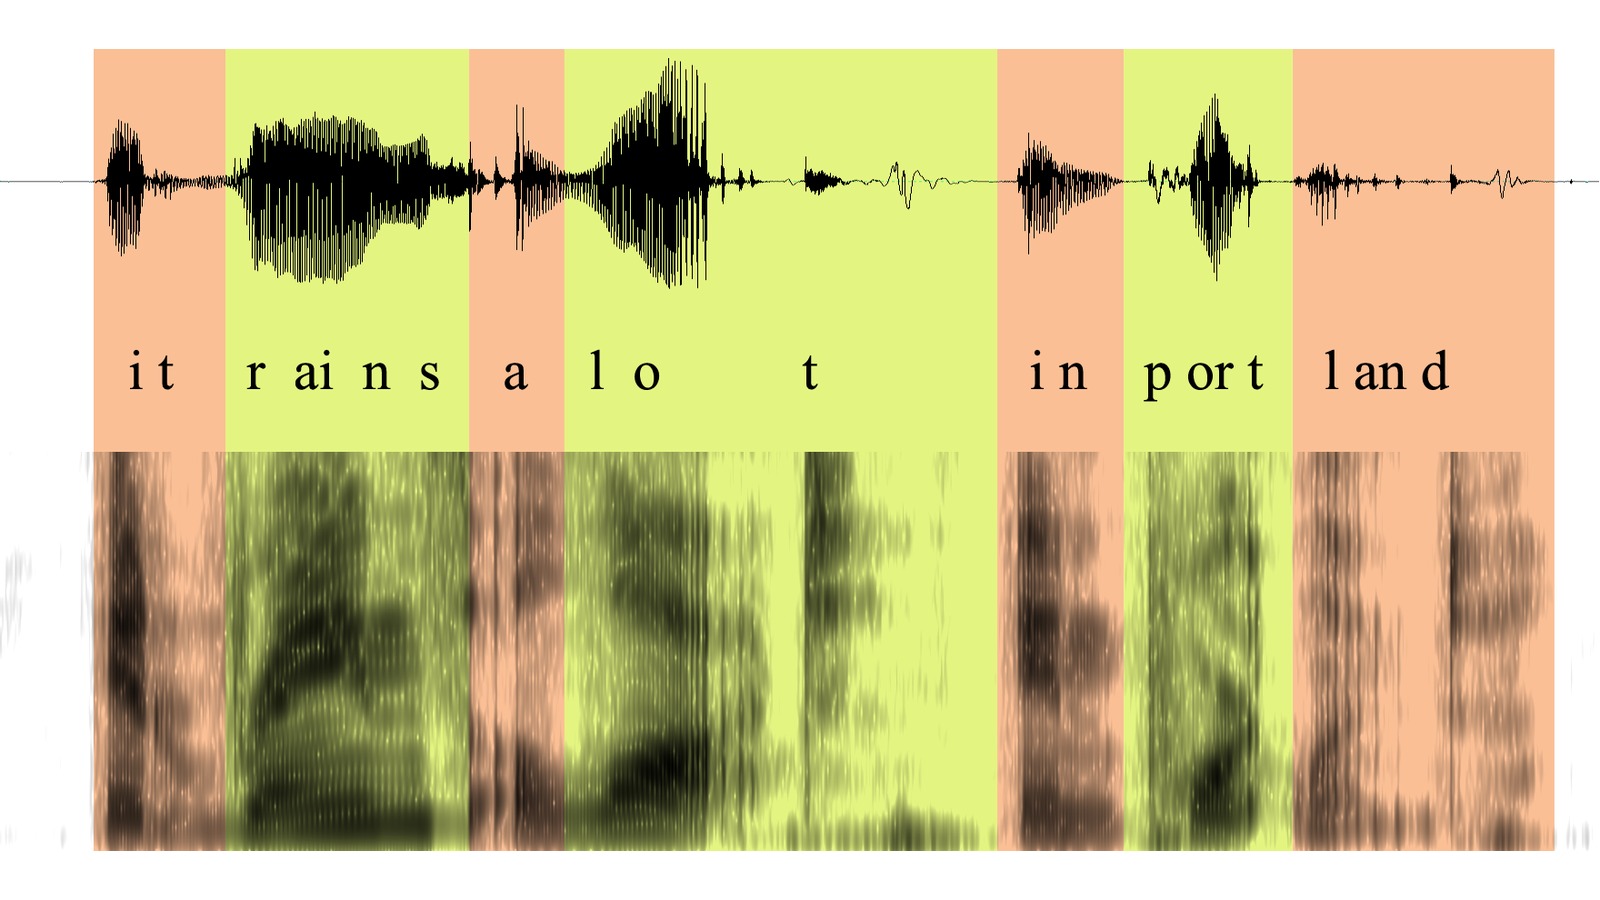
Gambar: Aaron Parecki, Wikimedia Commons, CC BY 2.0. Bentuk gelombang dan spektrogram dari kalimat "it rains a lot in Portland", dengan huruf-huruf diletakkan tepat di atas audio yang bersesuaian — inilah bahan mentah yang diolah setiap model pengenalan suara.
Apa yang sebenarnya Anda unduh ketika mengunduh model transkripsi
Model ASR — pengenalan suara otomatis, dipakai bergantian dengan STT atau ucapan ke teks — adalah program yang menerima audio dan menghasilkan teks. Itu saja tugasnya. Ia tidak memutuskan siapa yang berbicara, tidak merangkum, tidak tahu rapat Anda membahas apa. Ia mendengar kata lalu menuliskannya.
"Open weights" berarti laboratoriumnya menerbitkan berkas modelnya sendiri dalam bentuk jadi. Bobot sebuah model adalah kisi angka raksasa yang dipelajarinya saat pelatihan, dan menerbitkannya berarti Anda mengunduh berkas itu, menjalankannya di perangkat keras sendiri, dan membangun di atasnya tanpa meminta izin siapa pun atau membayar per permintaan. Alternatifnya adalah model tertutup: bobotnya tetap di server penyedia dan Anda menyewa akses lewat API — audio naik, teks kembali, dan penagihan dihitung per menit.
Angka di dalam nama adalah jumlah parameter, dan untuk model suara angka itu terasa luar biasa konkret. "0.6B" berarti sekitar 600 juta parameter, yang dalam praktiknya menjadikan Qwen3-ASR-0.6B berkas 1,56 GB dan Qwen3-ASR-1.7B berkas 4,08 GB — keduanya cukup kecil untuk duduk di SSD laptop tanpa ada yang menyadari. Bandingkan dengan model bahasa terbuka yang kami bahas di rangkuman gelombang model Tiongkok, di mana rilis utamanya berukuran 1,56 terabyte dalam 96 pecahan dan butuh klaster hanya untuk dimuat. Model suara sekitar seribu kali lebih kecil daripada model teks garis depan, dan fakta tunggal itulah yang membuat pergeseran ini terasa lebih keras di sini ketimbang di sana.
Sebut rentang ukuran ini kelas laptop: model yang cukup kecil sehingga mencobanya hanya membutuhkan unduhan, bukan keputusan anggaran perangkat keras. Kebanyakan model teks frontier tidak masuk kategori ini; banyak model suara muat.
Periksa lisensi sebelum mengadopsi model. Apache 2.0 dan MIT mengizinkan penggunaan, modifikasi, dan distribusi komersial. CC BY 4.0 yang digunakan model NVIDIA juga mengizinkan penggunaan komersial, tetapi mewajibkan atribusi.
Qwen merilis keluarga ini pada Januari; Juni adalah saat ia menjadi mudah
Sekarang rilis yang memicu tulisan ini, dengan satu koreksi atas cara ia diceritakan. Keluarga Qwen3-ASR tidak muncul pada bulan Juni. Repositori aslinya naik pada 28 Januari 2026, dan laporan teknisnya masuk arXiv sehari kemudian. Yang terjadi pada 26 Juni adalah Qwen menerbitkan versi -hf dari ketiga model itu — checkpoint yang berjalan secara native di Hugging Face Transformers mulai versi 5.13.0.
Perubahan pengemasan membuat penyiapan lebih familier: alih-alih memasang paket qwen-asr milik Qwen atau backend vLLM, pengembang yang menggunakan Transformers dapat memuat checkpoint -hf dengan Python standar. Ini mengurangi beban penyiapan tanpa mengubah kemampuan pengenalan model.
Spesifikasinya diambil langsung dari kartu model. Kedua ukuran melakukan identifikasi bahasa dan pengenalan suara untuk 30 bahasa — Inggris, Mandarin, Korea, Jepang, Spanyol, Arab, Hindi, Thai, Vietnam, Polandia, dan dua puluh lainnya — ditambah 22 dialek Tionghoa, dan begitulah angka "52 bahasa dan dialek" itu tercapai. Keduanya menjalankan inferensi streaming dan luring dari satu model yang sama, sesuatu yang lebih langka daripada kedengarannya: banyak model transkripsi hanya bisa salah satu. Keduanya menerima audio panjang, dan kartunya mencantumkan nyanyian serta lagu bermusik latar sebagai jenis audio yang didukung.
Model ketiga layak diberi jeda. Qwen3-ForcedAligner-0.6B melakukan penyelarasan paksa: beri dia audio dan sebuah transkrip, lalu ia menandai di mana setiap kata dimulai dan berakhir, hingga presisi milidetik, untuk 11 bahasa dan hingga lima menit ucapan sekali jalan. Itulah mesin di balik transkrip yang bisa diklik, penentuan waktu takarir, dan lompatan ke detik ketika seseorang mengucapkan sesuatu. Persis itulah yang ditampilkan gambar di awal tulisan ini. Menerbitkan penyelaras bersama pengenalnya adalah sinyal tentang untuk siapa rilis ini dibuat: bukan orang yang menjalankan demo, melainkan orang yang membangun produk.
Soal kualitas, pilah dulu siapa mengklaim apa. Kartu milik Qwen sendiri melaporkan angka dari Hugging Face Open ASR Leaderboard bertanggal 26 Juni 2026: rata-rata tingkat kesalahan kata 5,59 % untuk model 1.7B dan 6,31 % untuk 0.6B, dengan subset audio rapat AMI di 9,26 % dan 10,57 %. Tingkat kesalahan kata adalah proporsi kata yang salah ditangkap model, jadi makin rendah makin baik, dan AMI adalah angka tersulit di antaranya karena rapat sungguhan itu berantakan. Qwen juga menyebut versi 1.7B sebagai "yang tercanggih di antara model ASR sumber terbuka" dan setara dengan API komersial — perlakukan itu sebagai klaim vendor sampai ada pihak di luar Alibaba yang mengukurnya. Perhatikan pula bahwa ini tolok ukur yang berbeda dari papan independen di bawah, dengan audio berbeda, sehingga kedua kumpulan angka tidak bisa diperbandingkan satu sama lain.
Whisper yang memulai semuanya, dan masih model yang dijalankan semua orang
Semua ini tidak akan berbentuk seperti sekarang tanpa Whisper dari OpenAI. Repositorinya dibuka pada 16 September 2022 di bawah lisensi MIT — kode dan bobot sekaligus — di saat pengenalan suara yang serius berarti kontrak dengan penyedia awan. Sejak itu ia mengumpulkan 106.679 bintang di GitHub.
Yang membuat Whisper penting bukan modelnya, melainkan apa yang dibangun komunitas di atasnya dalam hitungan bulan. whisper.cpp menulis ulang model itu dalam C dan C++ murni, berlisensi MIT, 52.591 bintang, dan membuatnya berjalan di laptop dan ponsel tanpa Python dan tanpa GPU. faster-whisper membangunnya ulang di atas CTranslate2 dengan lompatan besar pada kecepatan dan memori, juga MIT, 24.750 bintang. Model itu benihnya; ekosistemnya pohonnya.
Empat tahun kemudian, Whisper masih digunakan secara luas. Dalam 30 hari sebelum 5 Agustus 2026, whisper-large-v3-turbo diunduh 8,72 juta kali dari Hugging Face dan whisper-large-v3 5,50 juta kali; Qwen3-ASR-0.6B mencapai 4,29 juta unduhan. Pada papan Artificial Analysis, Whisper Large v3 mencatat AA-WER 4,07%, dibandingkan 1,73% bagi model teratas dalam petikan tersebut.
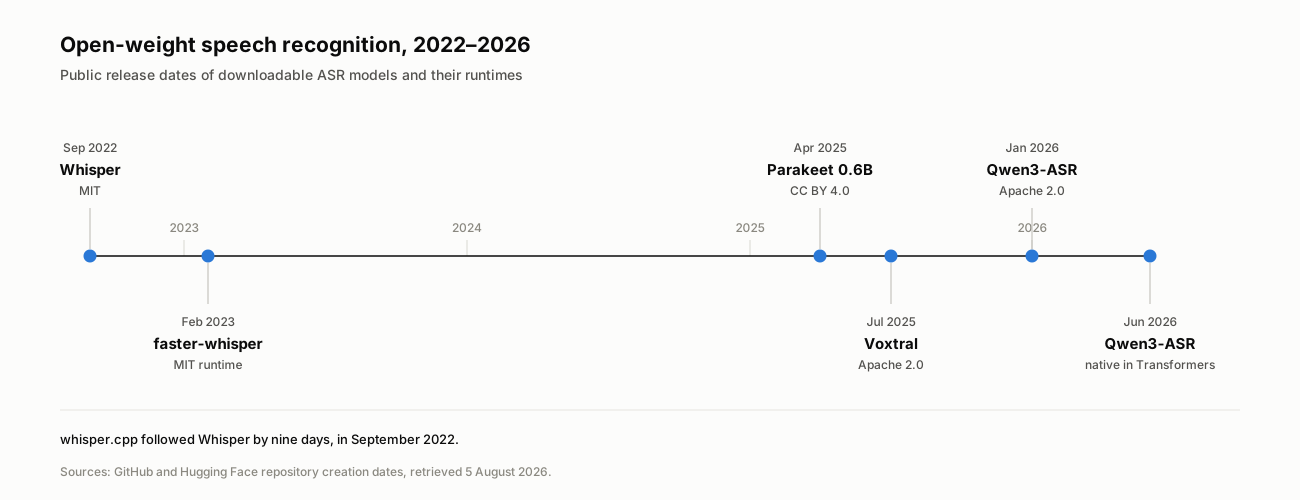
Lapisan suara terbuka datang dalam dua gelombang berjarak tiga tahun, dengan nyaris kosong di antaranya. Tanggal rilis dari GitHub dan Hugging Face, ditarik 5 Agustus 2026.
Sisi terbuka bukan cuma satu laboratorium
Qwen tidak sendirian, dan yang lain unggul di hal-hal yang jelas berbeda.
Lini Parakeet dari NVIDIA bertaruh pada kecepatan. parakeet-tdt-0.6b-v3, dirilis Agustus 2025 di bawah CC BY 4.0, adalah model 600 juta parameter yang mencakup 25 bahasa Eropa dengan deteksi bahasa otomatis, tanda baca, kapitalisasi, dan stempel waktu tingkat kata bawaan, serta melahap audio hingga 24 menit dalam sekali jalan. Keluarga Canary dari NVIDIA — canary-1b-v2 dan canary-qwen-2.5b, juga CC BY 4.0 — menutup wilayah serupa dengan taruhan arsitektur yang berbeda. Model Voxtral dari Mistral tiba pada Juli 2025 di bawah Apache 2.0, dan penting karena alasan yang segera kita bahas.
Berikut sisi terbuka disandingkan, dengan API terhosting di baris terakhir sebagai pembanding.
| Model | Unduhan | Lisensi | Bahasa | Berjalan di | Paling kuat pada |
|---|---|---|---|---|---|
| Whisper Large v3 | 3,09 GB | MIT | 99 | Laptop atau satu GPU | Menjadi bawaan yang sudah didukung semua perkakas |
| Qwen3-ASR-0.6B | 1,56 GB | Apache 2.0 | 52 dengan dialek | Laptop | Kerja multibahasa pada ukuran terkecil |
| Qwen3-ASR-1.7B | 4,08 GB | Apache 2.0 | 52 dengan dialek | Laptop atau satu GPU | Akurasi terbaik di keluarga Qwen |
| Parakeet TDT 0.6B v3 | 2,51 GB | CC BY 4.0 | 25 bahasa Eropa | Laptop atau satu GPU | Kecepatan dan stempel waktu tingkat kata |
| Voxtral Small | — | Apache 2.0 | — | GPU server, 24 miliar parameter | Skor terbuka tertinggi di papan independen |
| API terhosting | Tidak bisa diunduh | Tertutup | Bervariasi | Awan penyedia | Diarisasi, streaming, ketersediaan |
Ukuran unduhan adalah checkpoint bawaan di setiap repositori Hugging Face. "—" berarti materi sumber yang digunakan untuk perbandingan ini tidak mencantumkan nilainya. Petikan diambil pada 5 Agustus 2026.
Lalu ada kerja pengemasan yang membawa model-model ini ke perangkat sungguhan, titik di mana kelas laptop berhenti menjadi teori. whisperkit-coreml — Whisper yang dikompilasi untuk perangkat keras Apple — diunduh 8,31 juta kali dalam 30 hari terakhir. Build MLX Parakeet untuk Apple Silicon meraih 1,87 juta, dan dua konversi GGUF — format terkuantisasi yang menjalankan model di CPU biasa — meraih 2,04 juta dan 1,87 juta. Jutaan orang per bulan mengunduh pengenalan suara yang dikemas khusus agar berjalan di mesin mereka sendiri. Itu bukan keingintahuan riset. Itu kanal distribusi.
Peringkat satu masih endpoint pratinjau yang tidak bisa Anda unduh
Perbandingan ini memisahkan akurasi pengenalan dari manfaat operasional menjalankan model sendiri.
Kami menarik papan ucapan-ke-teks Artificial Analysis pada 5 Agustus 2026 — tolok ukur independen yang mengukur model terbuka dan tertutup pada audio yang sama, berbeda dari papan Hugging Face yang merupakan urusan sesama model terbuka. Puncak indeks AA-WER:
| Peringkat | Model | AA-WER | Bisa diunduh? |
|---|---|---|---|
| 1 | Fun-Realtime-ASR-preview | 1,73 % | Tidak — endpoint pratinjau |
| 2 | Scribe v2, ElevenLabs | 2,18 % | Tidak — API terhosting |
| 3 | MAI-Transcribe-1.5, Microsoft | 2,38 % | Tidak — API terhosting |
| 4 | Smallest AI Pulse Pro | 2,43 % | Tidak — API terhosting |
| 5 | Voxtral Small, Mistral | 2,77 % | Ya — Apache 2.0 |
| 6 | Gemini 3.1 Pro Preview, High | 2,82 % | Tidak — API terhosting |
| 11 | Whisper Large v3 | 4,07 % | Ya — MIT |
Sumber: papan peringkat ucapan-ke-teks Artificial Analysis, AA-WER v2, ditarik 5 Agustus 2026. Status ketersediaan unduhan dinilai dari lisensi yang diterbitkan tiap model.
Empat baris teratas menunjukkan bahwa model dengan skor tertinggi dalam snapshot ini semuanya terhosting, dan pemimpinnya merupakan endpoint pratinjau, bukan model yang dapat diunduh.
Sekarang baca baris kelima, karena ia mengoreksi koreksi tadi. Voxtral Small berlisensi Apache 2.0. Anda bisa mengunduhnya, menjalankannya di perangkat keras sendiri, dan mengirimkannya secara komersial — dan ia duduk di peringkat lima papan independen dengan 2,77 %, sekitar satu poin tingkat kesalahan kata di belakang sebuah model pratinjau tertutup. Diterjemahkan ke rapat satu jam berisi 6.300 kata, jurang itu setara sekitar 66 kata. Nyata, tetapi jauh dari jurang menganga seperti yang biasa disiratkan.
Untuk banyak beban kerja, model suara terbuka sudah dapat digunakan. Keputusan yang tersisa adalah apakah kesenjangan akurasi yang kecil sepadan dengan kendali dari hosting sendiri, atau apakah fitur tambahan layanan terhosting membenarkan biayanya.
Apa yang Anda dapat dengan menjalankannya sendiri, dan apa ongkosnya
Ada tiga hal yang mendorong tim ke arah hosting sendiri, dan tak satu pun soal akurasi.
Privasi yang pertama dan biasanya menentukan. Kalau Anda mentranskripsi konsultasi medis, wawancara hukum, atau percakapan SDM, "audio tidak keluar dari perangkat keras kami" bukan preferensi melainkan syarat pengadaan, dan model yang Anda hosting sendiri adalah satu-satunya arsitektur yang memenuhinya dengan bersih. Operasi luring yang kedua: model di perangkat tetap bekerja di pesawat, di ruang bawah tanah, di lantai pabrik, di lokasi tanpa sinyal. Justru itulah sebabnya whisper.cpp dan build GGUF punya angka unduhan seperti sekarang.
Biaya yang ketiga, dan di sini angkanya telanjang. Dari potret Artificial Analysis yang sama, harga per 1.000 menit audio: Whisper Large v3 yang dihosting di fal.ai seharga 0,50 dolar, Canary Qwen 2.5B dari NVIDIA di Replicate 0,74, Parakeet TDT 0.6B V3 di Together AI 1,50. Di sisi tertutup, Nova-3 dari Deepgram 4,30, MAI-Transcribe-1.5 6,00, dan Gemini 3.1 Pro Preview 18,15. Itu selisih 4 kali lipat terhadap Microsoft dan 12 kali lipat terhadap Google, hanya untuk menghosting model terbuka di server orang lain — sebelum Anda mempertimbangkan menjalankannya di server sendiri, yang di situ biaya marginal jam keseribu adalah listrik.
Angka kecepatan dalam snapshot yang sama mengunggulkan Parakeet TDT 0.6B V3 yang disajikan melalui Together AI pada 885x waktu nyata — sekitar empat detik untuk memproses satu jam audio. Deepgram Nova-3 mencapai 512x, Whisper Large v3 di Together 478x, dan MAI-Transcribe-1.5 189x. Pilihan tercepat yang tercantum ialah model berbobot terbuka, tetapi hasil ini mengukur hosting Together AI, bukan perangkat keras lokal.
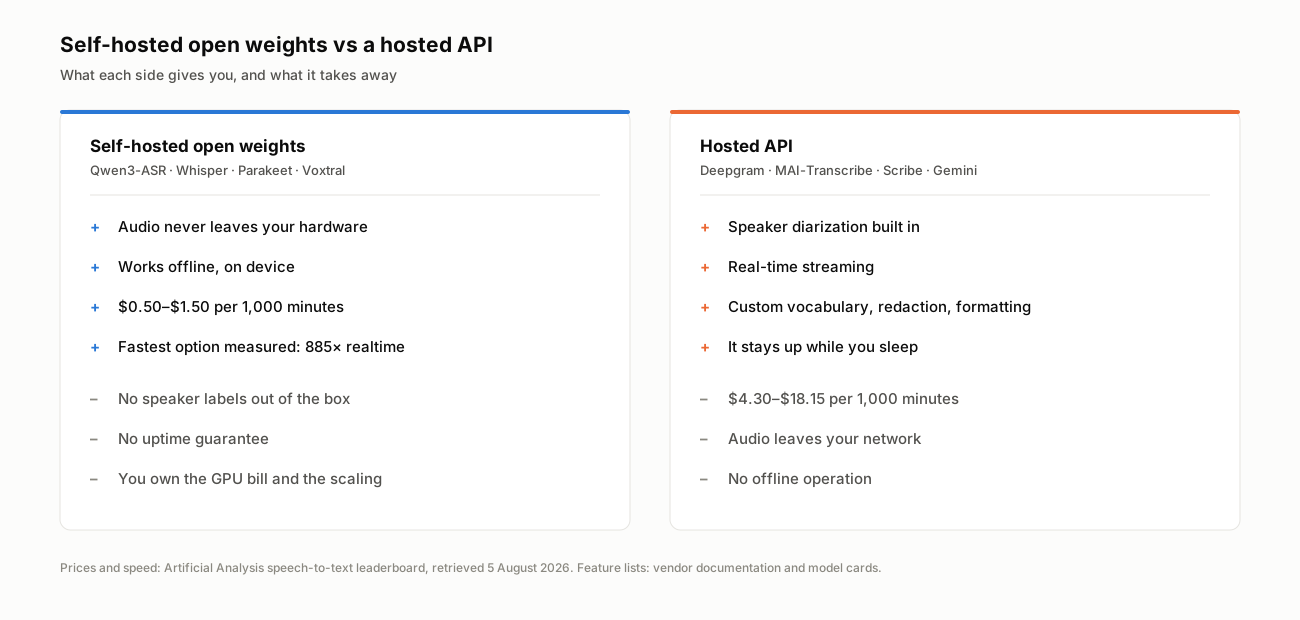
Pertukarannya tidak pernah akurasi lawan akurasi. Ini kendali dan biaya lawan fitur-fitur yang membungkus pengenalan.
Lalu apa yang masih dijual API terhosting? Segala hal yang bukan pengenalan. Dokumentasi Deepgram adalah inventaris yang jujur: diarisasi pembicara, streaming waktu nyata, pemformatan, kosakata khusus, penyamaran entitas, deteksi bahasa, dan jaminan operasional bahwa layanan tetap hidup selagi Anda tidur. Unduh Qwen3-ASR dan Anda dapat kata serta stempel waktu. Tanpa label pembicara, tanpa SLA, dan tagihan GPU, penskalaan, serta panggilan pukul tiga pagi menjadi milik Anda.
Model paling banyak diunduh di kategori ini bukan model transkripsi
Corak muat turun turut menunjukkan permintaan terhadap pengenalpastian penutur selain transkripsi.
Ketika Anda mengurutkan seluruh kategori pengenalan suara otomatis di Hugging Face berdasarkan unduhan, model di puncak bukan Whisper, bukan Qwen, bukan pula Parakeet. Ia pyannote/speaker-diarization-3.1, dengan 8,91 juta unduhan dalam 30 hari terakhir, dan model diarisasi pyannote kedua menempati peringkat lima dengan 5,26 juta. Diarisasi adalah mesin yang menentukan siapa berbicara kapan — lapisan tepat di atas transkripsi.
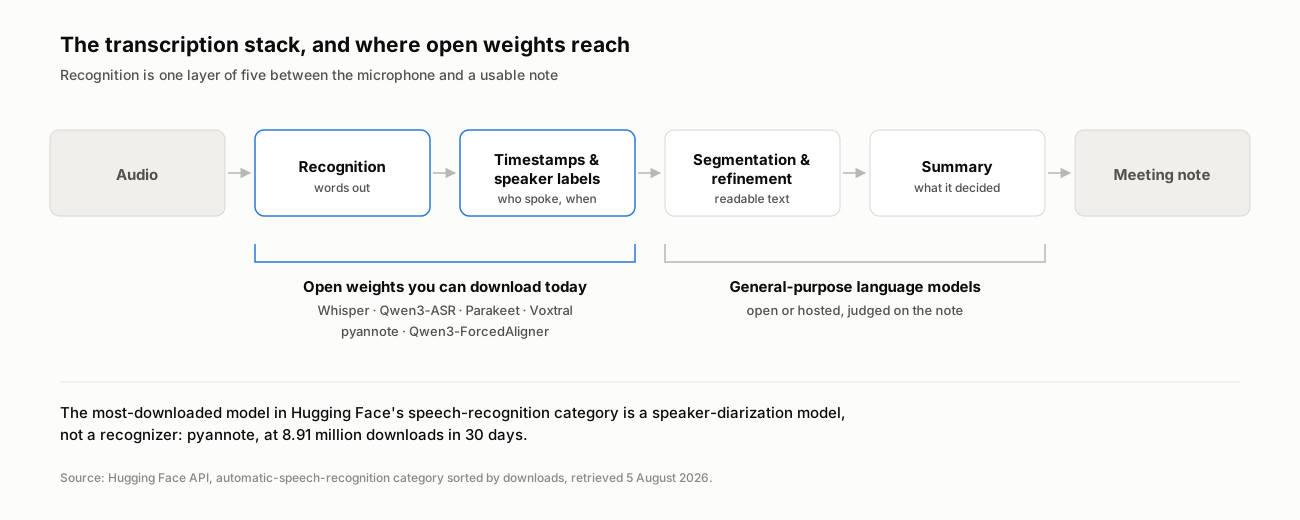
Bobot terbuka kini menutup dua lapisan pertama. Lapisan yang menentukan berguna atau tidaknya sebuah catatan ada di atasnya.
Model paling banyak dimuat turun dalam kategori pengecaman pertuturan sebenarnya tidak mengecam pertuturan; model itu mengenal pasti siapa yang bercakap dan bila. Permintaan tersebut menunjukkan lapisan di atas transkripsi, tempat label penutur membantu menjadikan perkataan yang dikenal pasti sebagai rekod mesyuarat yang berguna. Ini selari dengan jurang produk yang dihuraikan dalam analisis kami tentang pasaran tertutup.
Kesimpulan
Pertanyaan menarik tentang pengenalan suara open weight tidak pernah "apakah ia sebagus model tertutup". Ia berjarak sekitar satu poin tingkat kesalahan kata, ia lebih cepat, ia empat sampai dua belas kali lebih murah, dan ia muat di laptop. Pertanyaan menariknya adalah apa yang Anda bangun di ruang yang terbuka ketika transkripsi berhenti menjadi pos biaya sewaan — sebab berkas 1,56 GB yang mendengar 52 bahasa bukanlah produk. Ia komponen yang baru saja menjadi gratis.
Bagi tim yang sedang memilih alat catatan rapat alih-alih memilih model, bacaan praktisnya singkat. Apakah sebuah produk menjalankan model terbuka atau API tertutup kini sebagian besar tinggal detail implementasi, dan makin lama akan menjadi keduanya: bobot terbuka untuk pekerjaan bervolume besar, API terhosting di tempat diarisasi, streaming, dan skala membayar harganya. Telli.sh sudah menjalankan model terbuka di lapisan perangkumannya, sehingga kemajuan di sisi terbuka mengalir langsung ke transkripsi, terjemahan, dan catatan rapat tanpa perubahan harga. Nilailah alatnya dari apa yang keluar di ujung: apakah catatan itu memberi tahu Anda siapa berkomitmen pada apa.
Sumber
- Kartu model Qwen3-ASR-0.6B-hf (Hugging Face) — lisensi, daftar bahasa, angka papan peringkat bertanggal 26 Juni 2026
- Kartu model Qwen3-ASR-1.7B-hf (Hugging Face)
- Qwen3-ForcedAligner-0.6B (Hugging Face)
- Qwen3-ASR Technical Report, arXiv:2601.21337 (diajukan 29 Januari 2026)
- Repositori OpenAI Whisper (MIT, dipublikasikan 16 September 2022)
- whisper.cpp dan faster-whisper
- Kartu model NVIDIA parakeet-tdt-0.6b-v3 (CC BY 4.0)
- Mistral Voxtral-Small-24B-2507 (Apache 2.0)
- Papan peringkat ucapan-ke-teks Artificial Analysis — AA-WER v2, angka kecepatan dan harga ditarik 5 Agustus 2026
- Hugging Face Open ASR Leaderboard
- Dokumentasi Deepgram tentang diarisasi
- Halaman gambar di Wikimedia Commons
