Anthropic mulai menandai teks Claude dengan watermark — dan 1.922 perkara pengadilan menunjukkan apa yang tak bisa diperbaikinya
Penjelasan tentang cara watermark teks Claude mengidentifikasi kemungkinan keterlibatan model tanpa memverifikasi ketepatan fakta. Bahas batas deteksi, tuduhan keliru, serta perbedaan asal-usul dan kebenaran melalui 1.922 kasus halusinasi yang tercatat.
Pada 14 Agustus 2026, Anthropic menjelaskan cara kerja watermark teks pada model Claude mendatang. FAQ-nya mengaitkan peluncuran ini dengan persyaratan transparansi dalam Undang-Undang AI Uni Eropa, yang mulai berlaku pada 2 Agustus. Model yang dirilis sebelum tanggal itu akan diperbarui selama masa transisi; pengumuman ini bukan berarti setiap respons Claude sudah membawa watermark.
Gagasan utamanya adalah menyisipkan sinyal ke dalam pilihan kata model. Dalam kondisi yang tepat, sinyal itu dapat membantu mengidentifikasi keterlibatan model tanpa mengubah tampilan teks bagi pembaca.
Perbedaan ini penting ketika teks yang dihasilkan memuat bukti rekaan. Snapshot basis data publik yang dibahas di bawah mencatat 1.922 kasus pengadilan terkait konten halusinasi AI. Kasus-kasus ini bukan tes watermark, dan tidak membuktikan apakah detektor tertentu akan mengenali teks tersebut. Kasus itu menunjukkan masalah yang berbeda: sinyal asal-usul tidak dapat memastikan bahwa perkara, studi, atau fakta yang dikutip benar-benar ada. Memahami kesenjangan ini membuat hasil watermark lebih berguna dan lebih sulit disalahgunakan.
Ringkasnya:
- Tidak ada yang ditambahkan ke dalam teks. Kunci rahasia mengubah keacakan di balik pemilihan kata, bukan format yang terlihat. Anthropic merencanakan peluncuran global, dengan model lama ditambahkan secara bertahap.
- Hasil positif adalah bukti lemah, hasil negatif nyaris bukan bukti sama sekali. Anthropic sendiri menyatakan tanda itu tidak bisa membedakan "Claude menulis ini" dari "Claude banyak menyunting ini", lemah pada teks pendek, kode, dan paragraf faktual murni, serta terhapus oleh penulisan ulang. Pada 2024 para peneliti menunjukkan bahwa dengan kurang dari 50 dolar seseorang bisa menghapus tanda semacam ini sekaligus memalsukannya ke teks tulisan manusia.
- Asal-usul bukan verifikasi. Hasil deteksi dapat menunjukkan kemungkinan keterlibatan model, tetapi tidak memvalidasi perkara, kutipan, atau buku yang disebut dalam teks.
Gambar: Jon Rawlinson, Wikimedia Commons, CC BY 2.0. Satu halaman penuh tanda keaslian. Masing-masing membuktikan sebuah perbatasan telah dilintasi. Tak satu pun berkata apa-apa tentang apakah pemiliknya berkata jujur.
Apa yang sebenarnya diubah Anthropic, dan apa yang tidak
Mulailah dari mekanismenya, karena hampir semua salah paham setelah ini berawal dari keliru di sini.
Ketika model bahasa menulis, ia menghasilkan satu kata pada satu waktu, dan di sebagian besar posisi tidak ada satu pilihan yang benar. "Rapatnya produktif" dan "Rapatnya bermanfaat" sama-sama benar. Model menyimpan daftar kata berikutnya yang bisa diterima lalu memilih satu lewat undian acak. Itulah sebabnya perintah yang sama memberi Anda dua jawaban yang sedikit berbeda.
Watermark teks mengganti undian acak itu dengan undian semi-acak yang digerakkan sebuah kunci rahasia. Model tetap hanya memilih di antara kata-kata yang sudah dinilainya sama baiknya, jadi kualitas tidak tersentuh. Tetapi sepanjang beberapa ratus kata, pola tentang kata mana yang menang setiap kali berhenti tampak seperti kebetulan, dan siapa pun yang memegang kuncinya bisa mengukurnya.
Tidak ada karakter tersembunyi atau metadata teks yang dapat dilepas. Sinyalnya berasal dari pilihan kata, dan Anthropic menyatakan bahwa watermark tidak menambahkan token serta hanya berdampak kecil pada kecepatan. Kebijakan peluncurannya bersifat global, bukan regional, tetapi cakupan model tetap bergantung pada peluncuran bertahap; kebijakan itu sendiri tidak membuktikan bahwa respons tertentu sudah memiliki watermark.
Tidak ada yang baru secara ilmiah di sini. Scott Aaronson mengusulkan pendekatan ini pada 2022, Kirchenbauer dan rekan menerbitkan skema yang berfungsi di ICML 2023, dan Google DeepMind menerbitkan SynthID-Text di Nature pada Oktober 2024 — implementasi Anthropic adalah salah satu versinya. Google menjalankannya di Gemini sejak 2024, melaporkan sekitar 20 juta respons nyata tanpa perbedaan kualitas yang terdeteksi, dan sejak itu mengklaim lebih dari 10 miliar konten telah diberi watermark.
Pembaruan, 12 Oktober 2026: FAQ Anthropic yang diperbarui pada 1 September menjelaskan bahwa API deteksi berada dalam pratinjau privat untuk organisasi yang memenuhi syarat, dengan akses lebih luas direncanakan. Ini menggantikan status API "segera hadir" dalam gambaran awal bulan Agustus. Watermark memperkirakan keterlibatan Claude; ia tidak memeriksa apakah teks itu benar.
Tanda itu bertahan saat disalin-tempel. Ia tidak bertahan saat ditulis ulang.
Sinyalnya hidup pada kata-kata mana yang dipilih, jadi apa pun yang mempertahankan pilihan kata akan mempertahankan tandanya, dan apa pun yang menggantinya akan menghancurkannya. Anthropic menyatakan batasnya dengan gamblang: "penulisan ulang menyeluruh di mana setiap kata diganti akan" menghapusnya. Ada dua kasus yang mematahkan pola ini dengan cara yang sering mengecoh orang.
Teks pendek dan teks faktual nyaris tak membawa apa-apa. Watermark butuh pilihan untuk bersembunyi. Satu atau dua kalimat tidak menyediakan cukup keputusan untuk membentuk pola, dan konten yang sangat faktual bisa jadi tak menyediakan pilihan nyata sama sekali — contoh Anthropic sangat jelas: setelah "Principia karya Newton", kata berikutnya pasti "Mathematica", dan tak ada kunci mana pun yang punya suara. Logika yang sama melemahkan kode, di mana sintaksis menentukan sebagian besar token, serta penyuntingan naskah, ketika model mengubah terlalu sedikit kata untuk meninggalkan sinyal.
Terjemahan membawa watermark penuh. Yang ini berlawanan dengan naluri. Minta Claude menerjemahkan sebuah dokumen ke bahasa Jepang, dan teks Jepang itu dihasilkan baru oleh Claude, kata demi kata, dengan kebebasan memilih seperti biasa — sehingga keluar dengan tanda penuh, meski gagasannya berasal dari naskah manusia yang tak bertanda. Ini kebalikan dari yang digambarkan para peneliti DeepMind di Nature, bahwa menerjemahkan teks bertanda ke bahasa lain sangat menurunkan keyakinan deteksi. Keduanya benar karena skenarionya berbeda: menerjemahkan teks bertanda di tempat lain akan meluruhkan tandanya, sedangkan meminta model sendiri yang menerjemahkan justru membubuhkan tanda baru.
| Yang Anda lakukan pada teks | Apakah tandanya bertahan? |
|---|---|
| Menyalin dan menempel ke mana saja | Ya — tak ada yang tertanam yang bisa dilepas oleh penempelan |
| Penyuntingan ringan: salah ketik, judul, pemangkasan | Ya — sebagian besar pilihan kata tetap utuh |
| Meminta model menerjemahkannya | Ya — terjemahan dihasilkan baru, jadi bertanda penuh |
| Parafrase berat dengan kata-kata Anda sendiri | Tidak — Anda mengganti pilihan yang membawa sinyalnya |
| Penulisan ulang total, setiap kata diganti | Tidak — Anthropic menyatakan ini menghapusnya |
| Kutipan pendek satu atau dua kalimat | Lemah sampai nihil — terlalu sedikit pilihan untuk membentuk pola |
| Kode, atau paragraf faktual murni | Lemah — sintaksis dan fakta tak menyisakan kebebasan bagi model |
| Meminta model menyunting draf Anda | Lemah sampai nihil — terlalu sedikit kata yang berubah |
Perilaku sesuai pernyataan Anthropic dalam FAQ 14 Agustus 2026 (diperbarui 1 September) dan para penulis SynthID-Text di Nature, Oktober 2024.
Hasil positif adalah bukti lemah. Hasil negatif nyaris bukan bukti.
Jika detektor memberikan hasil, kesimpulan apa yang masuk akal untuk ditarik?
Kalau hasilnya positif: bahwa sebagian teks ini pernah melewati model penyedia tersebut. Hanya itu. Anthropic menyatakan terang-terangan bahwa tanda itu tidak bisa membedakan "Claude menulis ini" dari "Claude banyak menyunting ini", tidak berkata apa pun tentang benar tidaknya satu klaim di dalamnya, dan tidak mengenali teks dari AI lain, karena ia hanya mengenal kuncinya sendiri.
Kalau hasilnya negatif, ia nyaris tak tahu apa-apa. Hasil bersih persis sama dengan yang Anda dapat dari parafrase berat, kutipan pendek, blok kode, model pesaing, atau model berbobot terbuka yang berjalan di laptop seseorang tanpa penandaan sama sekali.
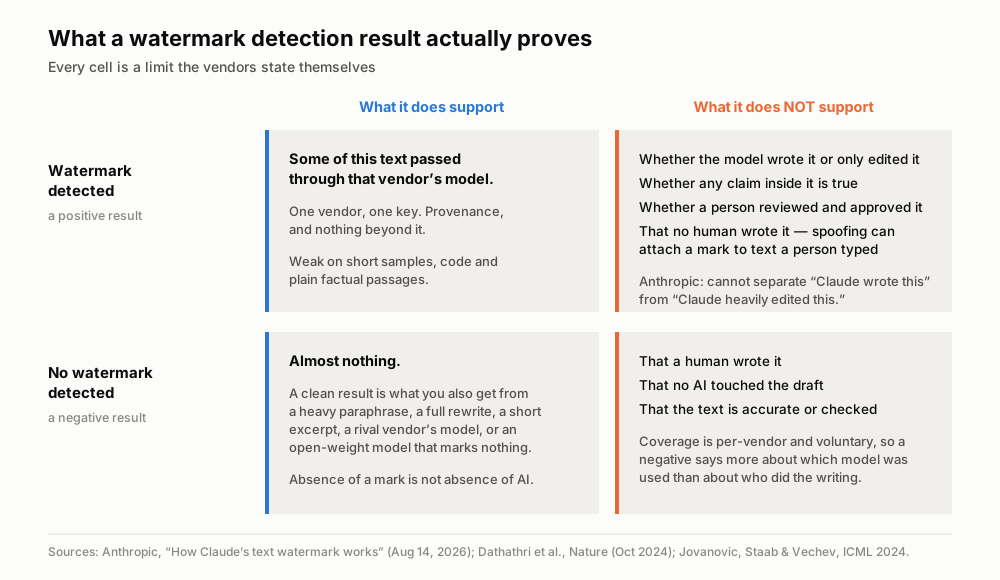
Setiap sel di sini adalah batasan yang dipublikasikan sendiri oleh para penyedia. Sumber: FAQ watermark Anthropic (14 Agustus 2026, diperbarui 1 September); Dathathri dkk., Nature (Oktober 2024); Jovanović, Staab dan Vechev, ICML 2024.
Serangan yang tak dianggarkan siapa pun justru berjalan terbalik
Penghapusan adalah risiko yang dibayangkan semua orang: seseorang mencuci teks AI untuk menyembunyikan asal-usulnya. Baiklah. Tetapi ada serangan kedua dengan panah menunjuk ke arah sebaliknya, dan itulah yang seharusnya membuat Anda khawatir.
Pemalsuan berarti membuat teks yang ditulis manusia membawa watermark milik orang lain. Tak ada yang disembunyikan; ada sesuatu yang ditanamkan. Sasarannya adalah orang yang kemudian dituduh memakai AI, atau penyedia yang disalahkan atas keluaran yang tak pernah ia hasilkan.
Di ICML 2024, Jovanović, Staab, dan Vechev mendemonstrasikan kedua serangan terhadap skema tercanggih dengan tingkat keberhasilan di atas 80% dan biaya komputasi kurang dari 50 dolar. Para penulis DeepMind mengakui hal yang sama dalam makalah Nature mereka sendiri: watermark "tidak menawarkan solusi yang lengkap", memerlukan kerja sama penyedia model bahkan sekadar untuk ada, tak bisa dipaksakan pada model berbobot terbuka yang bisa dijalankan siapa saja apa adanya, dan "rentan terhadap serangan pencurian, pemalsuan, dan penghapusan". Anak kalimat terakhir itu adalah seluruh argumennya, ditulis oleh tim yang membangun teknologinya.
Detektor AI awal menuduh mahasiswa yang salah
Alat deteksi sudah lama ada, dan itu teknologi yang berbeda dengan riwayat kerugian yang terdokumentasi. Watermark ditanamkan saat pembuatan oleh pemilik model, memakai kunci. Pengklasifikasi menebak setelah kejadian, dari ciri-ciri teksnya sendiri: seberapa mudah pilihan katanya ditebak, seberapa beragam kosakatanya. Yang pertama tahu sesuatu. Yang kedua sekadar mencocokkan pola gaya. Itulah beda antara mengukur dan memprofil.
OpenAI meluncurkan AI Text Classifier pada 31 Januari 2023 dan mematikannya pada 20 Juli tahun yang sama "karena tingkat akurasinya yang rendah". Angka mereka sendiri: menangkap 26% teks AI dan salah menandai 9% teks manusia.
Lalu Liang dan rekan menerbitkan di Patterns pada Juli 2023 temuan yang seharusnya menutup kategori ini. Dengan tujuh detektor yang diuji pada esai TOEFL karya penutur non-asli bahasa Inggris, tingkat positif palsu rata-rata mencapai 61,3%; satu detektor menandai 97,8% di antaranya. Ketika esai yang sama diminta ditulis ulang dengan kosakata yang lebih kaya, angkanya turun ke 11,6%. Para detektor itu tak pernah mengukur kepengarangan: mereka mengukur kefasihan, dan menghukum siapa pun yang bahasa Inggrisnya lebih sederhana.
Universitas Vanderbilt menonaktifkan detektor AI Turnitin pada 16 Agustus 2023. Penjelasannya menggunakan perhitungan hipotetis: jika tingkat positif palsu 1% yang diklaim diterapkan pada sekitar 75.000 makalah yang diserahkan, kira-kira 750 makalah dapat keliru ditandai. Itu adalah perkiraan risiko, bukan jumlah mahasiswa yang benar-benar dituduh. Pengumuman Vanderbilt.
Deteksi watermark menguji pola generasi yang terdefinisi, bukan menyimpulkan kepengarangan dari gaya tulisan. Hasilnya tetap bersifat probabilistik, dan bagian pendek atau yang banyak disunting bisa tidak konklusif. Hasil tentang keterlibatan model tidak seharusnya berubah menjadi tuduhan terhadap orang tertentu; riset pemalsuan juga menunjukkan mengapa deteksi saja tidak dapat memastikan kepengarangan.
Regulasi datang lebih dulu daripada alatnya
Semua ini menumpuk dalam dua pekan karena pembuat undang-undang bergerak lebih dulu.
UU AI Uni Eropa membelah kewajiban menjadi dua. Pasal 50(2) mengikat penyedia: siapa pun yang membangun sistem generatif harus menandai keluarannya secara terbaca mesin, termasuk teks. Pasal 50(4) mengikat Anda: penerap yang menerbitkan teks buatan AI yang "memberi informasi kepada publik mengenai hal-hal yang menyangkut kepentingan publik" wajib mengungkapkannya.
Dan yang kedua itu membawa pengecualian yang, bagi sebagian besar pembaca, merupakan inti praktis dari seluruh rezim ini. Kewajiban tersebut tidak berlaku bila konten telah melalui tinjauan manusia atau kendali redaksional dan ada orang yang memikul tanggung jawab redaksional atasnya. Baca dua kali. Jawaban Eropa atas teks buatan AI bukan sebuah detektor. Ia adalah manusia bernama yang telah meninjaunya dan bertanggung jawab atasnya.
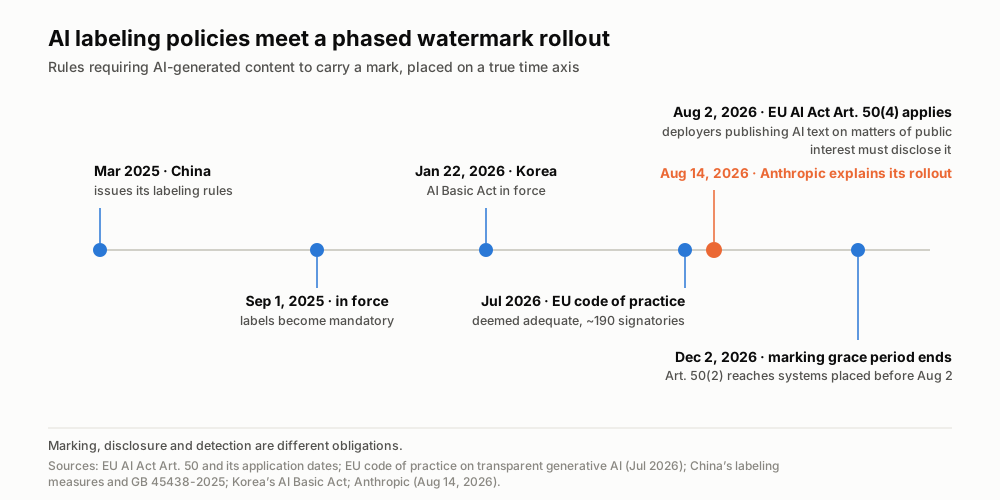
Kewajiban pelabelan datang sesuai jadwal; deteksi yang bisa dipakai tidak. Sumber: UU AI Uni Eropa dan tanggal penerapannya, kode etik transparansi Uni Eropa (Juli 2026), aturan pelabelan Tiongkok dan standar GB 45438-2025, UU Dasar AI Korea, serta pengumuman Anthropic.
Komisi Eropa menjelaskan bahwa kode transparansinya adalah kerangka kepatuhan sukarela, bukan pengganti hukum; sekitar 190 organisasi telah menandatanganinya pada akhir Juli 2026. FAQ-nya memberi masa transisi hingga 2 Desember 2026 bagi sistem yang ditempatkan di pasar sebelum 2 Agustus. Perbedaan ini penting: jadwal penerapan oleh penanda tangan dan kewajiban hukum bukanlah hal yang dapat dipertukarkan. Ikhtisar Komisi, FAQ Komisi.
Yurisdiksi lain menerapkan aturan yang berbeda. Aturan pelabelan Tiongkok berlaku sejak 1 September 2025, dengan label terlihat dan tertanam berdasarkan standar GB 45438-2025. UU Dasar AI Korea berlaku sejak 22 Januari 2026. Untuk menilai kepatuhan, pembaca perlu mempertimbangkan yurisdiksi dan jenis konten yang berlaku, bukan menganggap ada satu aturan pelabelan global.
Satu ketiadaan lagi pantas ditaruh di sini. Wall Street Journal memberitakan pada 2024 bahwa OpenAI telah membangun metode watermark teks yang secara internal digambarkan berakurasi sekitar 99,9%. Perlakukan itu sebagai laporan pers, bukan fakta: angkanya tak pernah diverifikasi secara independen dan OpenAI tak pernah meluncurkan penandaan teks. Tulisan mereka sendiri tertanggal 11 Juni 2026 tentang kepatuhan di Uni Eropa hanya mendokumentasikan asal-usul gambar, dan mengakui batas umumnya dengan kata-kata mereka sendiri: "metadata bisa dihapus, watermark bisa memudar".
Watermark tidak dapat mengesahkan kutipan yang berhalusinasi
Damien Charlotin mengelola basis data publik berisi putusan pengadilan dari seluruh dunia yang mengharuskan hakim menangani konten buatan AI yang mengandung halusinasi. Diambil pada 16 Agustus 2026, angkanya 1.922 putusan. Lintasannya: sekitar 200 pada pertengahan 2025, 719 pada Januari 2026, 1.227 pada April, 1.598 pada 9 Juni, dan 1.922 hari ini — 324 di antaranya bertambah hanya dalam sepuluh pekan terakhir.
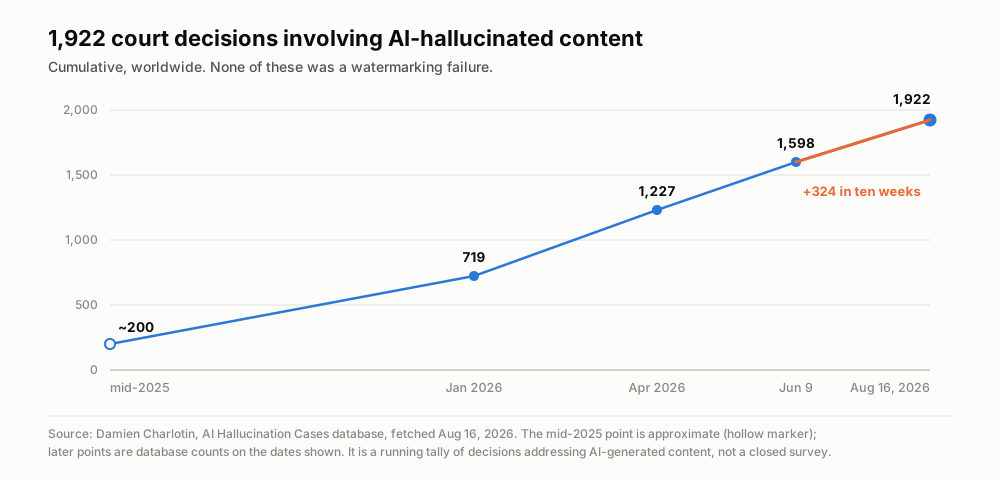
Kasus-kasus ini mencatat halusinasi, bukan hasil pengujian watermark. Tanda asal-usul tidak dapat mengesahkan klaim faktualnya. Sumber: basis data kasus halusinasi AI milik Damien Charlotin, diambil 16 Agustus 2026.
Arketipenya adalah Mata v. Avianca, diputus di Distrik Selatan New York pada 22 Juni 2023: sebuah memori hukum yang mengutip enam putusan pengadilan yang tidak pernah ada, dan sanksi 5.000 dolar.
Contoh yang paling berarti justru melibatkan Anthropic. Pada Mei 2025, dalam Concord Music v. Anthropic, pengacara perusahaan itu mengajukan deklarasi ahli yang mengutip studi yang dihalusinasikan Claude. Pemeriksaan manual luput menemukannya; penasihat hukum meminta maaf kepada pengadilan. Perusahaan yang kini menyediakan watermark teks juga pernah dirugikan oleh kutipan tanpa pemeriksaan kritis atas keluaran modelnya sendiri dalam litigasinya sendiri, meski ditinjau pengacaranya sendiri. Hasil watermark yang positif sekalipun tidak dapat membuktikan apakah studi yang dikutip benar-benar ada.
Ini meluas melampaui ruang sidang. Deloitte Australia setuju pada Oktober 2025 untuk mengembalikan sebagian pembayaran atas laporan pemerintah senilai 440.000 dolar Australia yang memuat rujukan tak berwujud dan kutipan rekaan dari sebuah putusan. Pada 18 Mei 2025, Chicago Sun-Times dan Philadelphia Inquirer memuat daftar bacaan musim panas yang disebarkan lewat sindikasi, yang dari lima belas bukunya hanya lima yang benar-benar ada. Liang dan rekan, menganalisis 950.965 makalah dalam arXiv:2404.01268, menemukan konten hasil modifikasi LLM mencapai 17,5% pada abstrak ilmu komputer, berbanding 6,3% atau kurang di matematika dan portofolio Nature.
Soal volume juga pantas mendapat angka yang jujur alih-alih yang mengagetkan. Analisis Common Crawl oleh Graphite yang terbit Oktober 2025 menemukan sekitar 51,7% artikel baru dalam sampel ditulis AI pada Mei 2025 — dan Axios, saat memberitakannya, menambahkan catatan yang penting: proporsi itu mendatar di sekitar separuh alih-alih terus menanjak. Ini bukan banjir bandang. Ini kenormalan baru.
Inilah intinya. Tak ada satu pun dalam daftar itu yang merupakan kegagalan watermark. Pada setiap kasus, asal-usulnya tak pernah diperdebatkan: semua orang tahu ada model yang terlibat, atau akan langsung menerimanya. Yang gagal adalah tak seorang pun membuka rujukan itu dan memeriksa apakah perkara, studi, atau buku tersebut benar-benar ada.
Kesimpulannya: asal-usul bukan verifikasi
Sebut saja ini kekeliruan cap pos. Cap pos membuktikan kantor mana yang menangani surat itu. Ia tak pernah punya pendapat tentang apakah isi suratnya benar. Kita baru saja menuangkan banyak sekali upaya rekayasa untuk membuat cap pos yang sangat bagus, dan sebagian percakapan publik nyaris mengiranya sebagai pemeriksa fakta.
Pegang tiga hal sekaligus. Deteksi positif ialah bukti kemungkinan keterlibatan model, bukan kepengarangan atau kebenaran. Hasil negatif tidak membuktikan bahawa teks itu ditulis manusia. Cakupan bergantung pada penyedia, kuncinya dan model yang menggunakan watermark; ia tidak menyeluruh. API pratinjau privat Anthropic yang diperbarui juga menetapkan syarat kelayakan, bukannya akses publik tanpa batas.
Yang benar-benar tahan diperiksa bukanlah tanda pada keluaran, melainkan catatan yang bisa Anda turunkan ulang dari sumbernya: rekaman yang masih ada, transkrip berstempel waktu yang memungkinkan Anda melompat kembali ke momen yang dipersoalkan, kalimat yang dinisbahkan pada orang yang benar-benar mengucapkannya, klaim yang bisa dilacak sampai ke dokumen primer yang bisa Anda buka. Kami sudah pernah membahasnya soal terjemahan langsung, di mana catatan yang bisa ditinjau lebih penting daripada keluaran yang lancar, dan soal transkripsi pemeriksaan kepolisian, di mana catatan harus bertahan ketika ada yang menyanggahnya. Era watermark tidak mengubah argumen itu, melainkan mempertajamnya: begitu penandaan menjadi universal, kalimat "ada AI yang terlibat" berhenti membedakan apa pun.
Watermark menjawab dari mana sebuah teks berasal. Sesuatu yang menjawab apakah teks itu benar belum dibangun siapa pun, karena benda itu bukan detektor. Ia adalah sumber yang bisa Anda datangi kembali.
Di mana Telli.sh berperan: kami membangun persis sumber yang bisa Anda datangi kembali itu. Telli.sh merekam rapat, menghasilkan transkrip berstempel waktu dengan pembicara yang teridentifikasi, dan menjaga ringkasannya tetap tertambat pada audio asalnya — sehingga baris mana pun dalam catatan Anda bisa dilacak, berbulan-bulan kemudian, sampai ke detik ketika seseorang mengucapkannya. Ini bukan klaim soal mendeteksi AI. Ini separuh lain dari persoalan: ketika sebuah ringkasan mengklaim sesuatu, Anda bisa mencocokkannya dengan rekaman alih-alih memercayai kalimatnya.
Sumber
- Anthropic, "How Claude's text watermark works" (Agustus 2026)
- Dathathri et al., "Scalable watermarking for identifying large language model outputs," Nature (Oktober 2024)
- Kirchenbauer et al., "A Watermark for Large Language Models," ICML 2023
- Jovanović, Staab & Vechev, "Watermark Stealing in Large Language Models," ICML 2024
- Liang et al., "GPT detectors are biased against non-native English writers," Patterns (Juli 2023)
- Liang et al., "Mapping the Increasing Use of LLMs in Scientific Papers," arXiv:2404.01268
- Damien Charlotin, basis data kasus halusinasi AI
- Komisi Eropa, Pasal 50 UU AI: kewajiban transparansi
- Halaman gambar di Wikimedia Commons
